일부러 결함을 만들어, 기존 테스트가 놓치는 빈틈을 찾는 방법.
테스트를 모두 실행했고,
결과도 전부 통과했다.
그렇다면 충분히 검증됐다고 볼 수 있을까?
테스트가 통과했다는 것은
이미 만들어진 테스트에서 문제가 발견되지 않았다는 뜻이다.
하지만 실제로 문제가 생겼을 때
지금의 테스트가 그 문제까지 잡아낼 수 있는지는 다른 문제다.
Meta는 이를 확인하기 위해
오히려 코드에 일부러 결함을 만들어 넣었다.
버그를 찾기 위해, 왜 버그를 먼저 만들었을까?
Meta의 ACH 사례를 통해
AI로 기존 테스트의 빈틈을 확인하고 보완하는 과정을 살펴본다.
[목차]
1. 테스트가 모두 통과하면 충분한 걸까?
1) 커버리지가 높으면 버그도 더 잘 잡을까?
테스트가 충분한지 확인할 때 자주 사용하는 지표 중 하나가
코드 커버리지(Code Coverage)다.
작성한 테스트가 실제 코드의 어느 범위까지 실행됐는지를 보여주는 지표로,
테스트되지 않은 코드를 찾고 어디에 테스트를 추가해야 할지 판단하는 데 유용하다.
그렇다면 커버리지가 높을수록
더 많은 버그를 발견할 수 있다는 뜻일까?
반드시 그렇지는 않다.
코드를 실행했다는 것과
그 코드에서 발생할 수 있는 문제를 검증했다는 것은 다르기 때문이다.
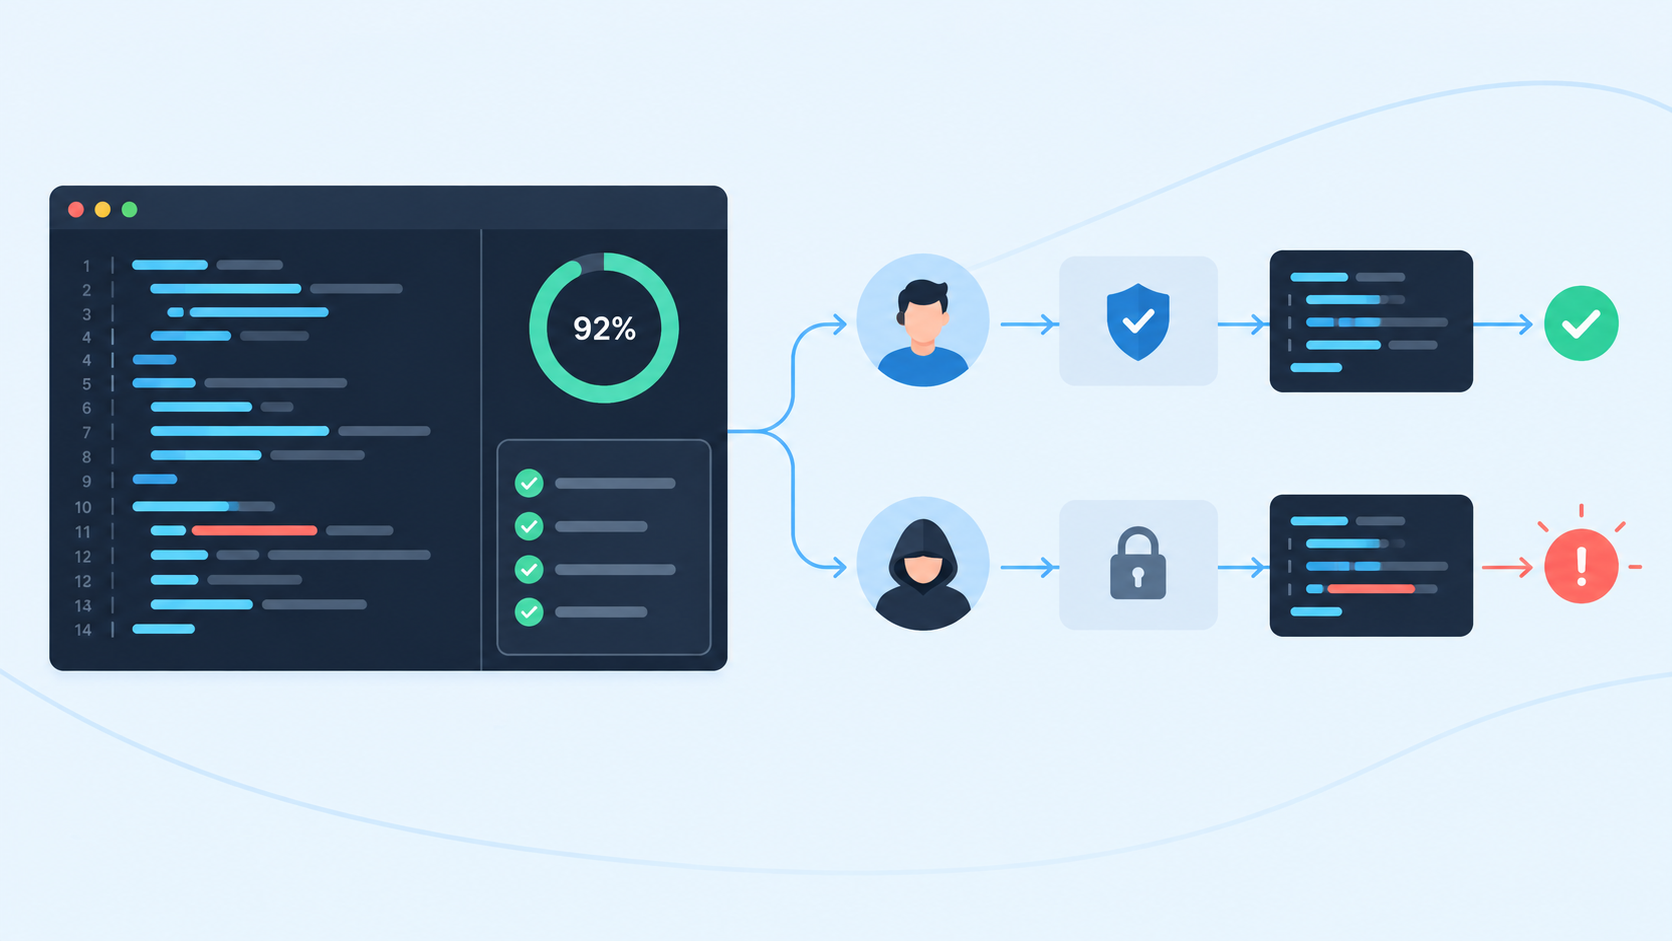
예를 들어 사용자 정보를 반환하는 기능을 테스트하면서
권한이 있는 사용자의 접근만 확인했다고 해보자.
관련 코드는 테스트를 통해 실행됐기 때문에 Coverage에는 포함된다.
하지만 권한이 없는 사용자의 접근을 제대로 차단하는지는 확인하지 못했을 수 있다.
코드는 실행됐다.
하지만 발생할 수 있는 모든 문제를 검증한 것은 아니다.
결국 Coverage만으로는
현재 테스트가 실제 결함을 얼마나 잘 발견할 수 있는지까지 알기 어렵다.
실제로 Meta의 ACH 연구에서는
새롭게 생성한 테스트의 약 49%가 Line Coverage를 높이지 않았지만,
기존 테스트가 놓치던 결함을 잡아냈다.
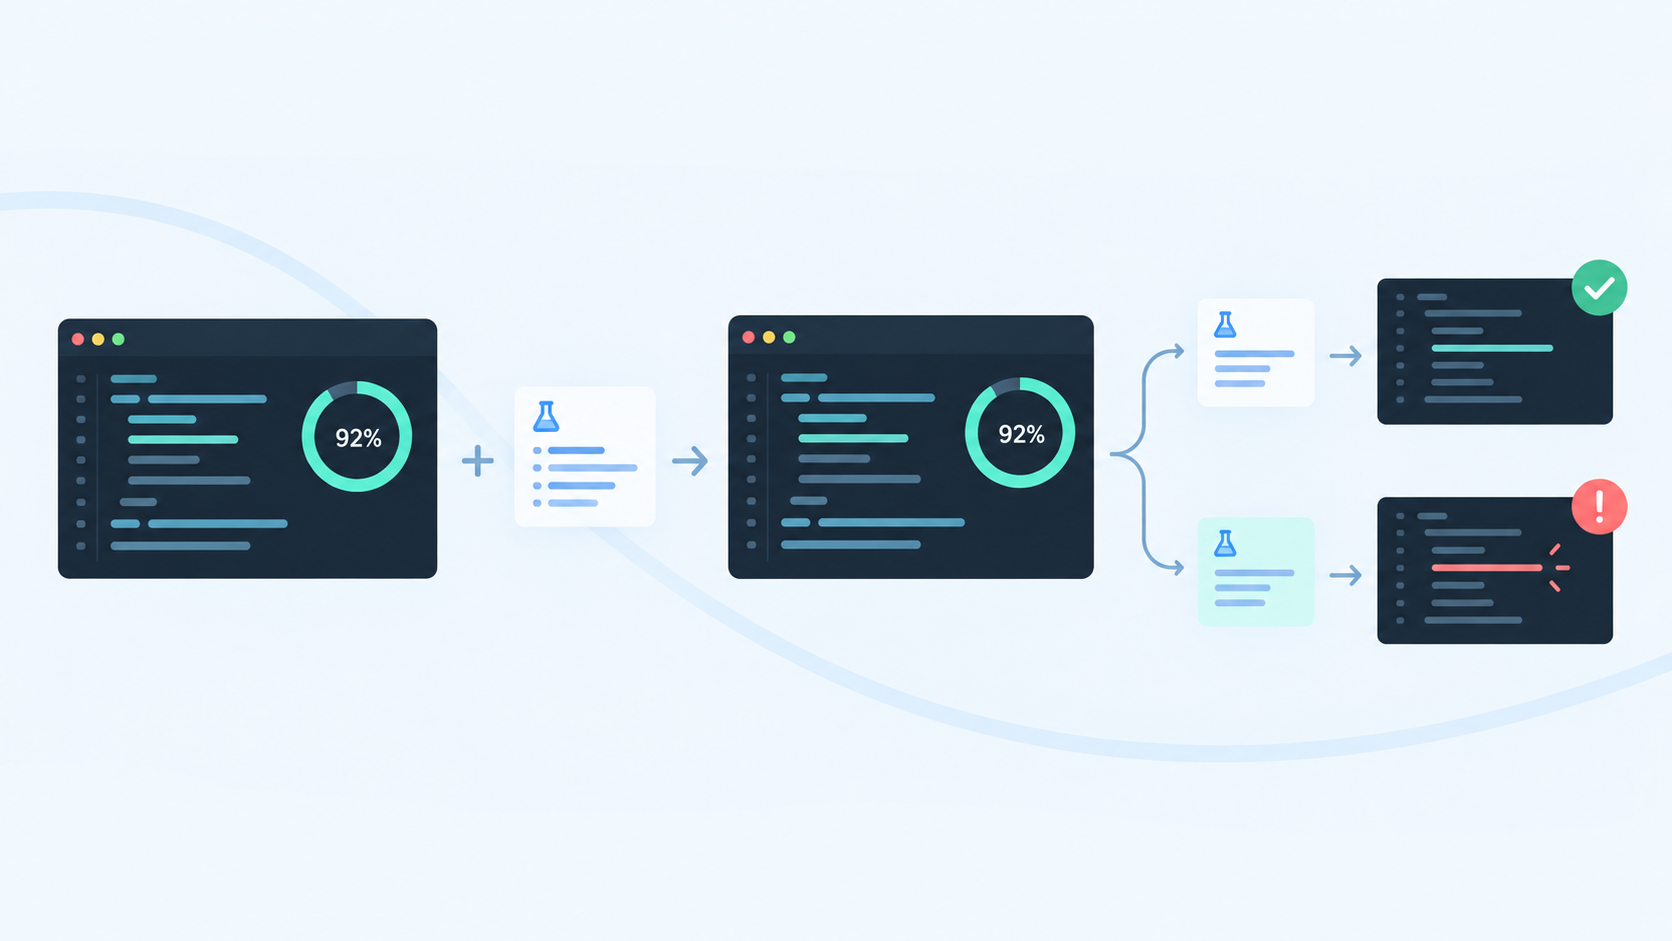
더 많은 코드를 실행하지 않았는데,
어떻게 더 많은 결함을 잡을 수 있었을까?
이를 확인하려면 먼저
Meta가 기존 테스트를 평가한 방법부터 살펴볼 필요가 있다.
2) Meta는 테스트를 확인하기 위해 일부러 버그를 만들었다
Meta가 활용한 방법은 오히려 반대 방향이었다.
테스트가 버그를 잡는지 확인하기 위해,
코드에 일부러 버그를 만들어 넣었다.
결함을 넣었는데도 기존 테스트가 모두 통과한다면,
현재 테스트가 그 문제를 발견하지 못한다는 뜻이다.
이렇게 정상 코드를 의도적으로 변경해 결함을 만들고,
기존 테스트가 이를 탐지하는지 확인하는 방법을 Mutation Testing이라고 한다.
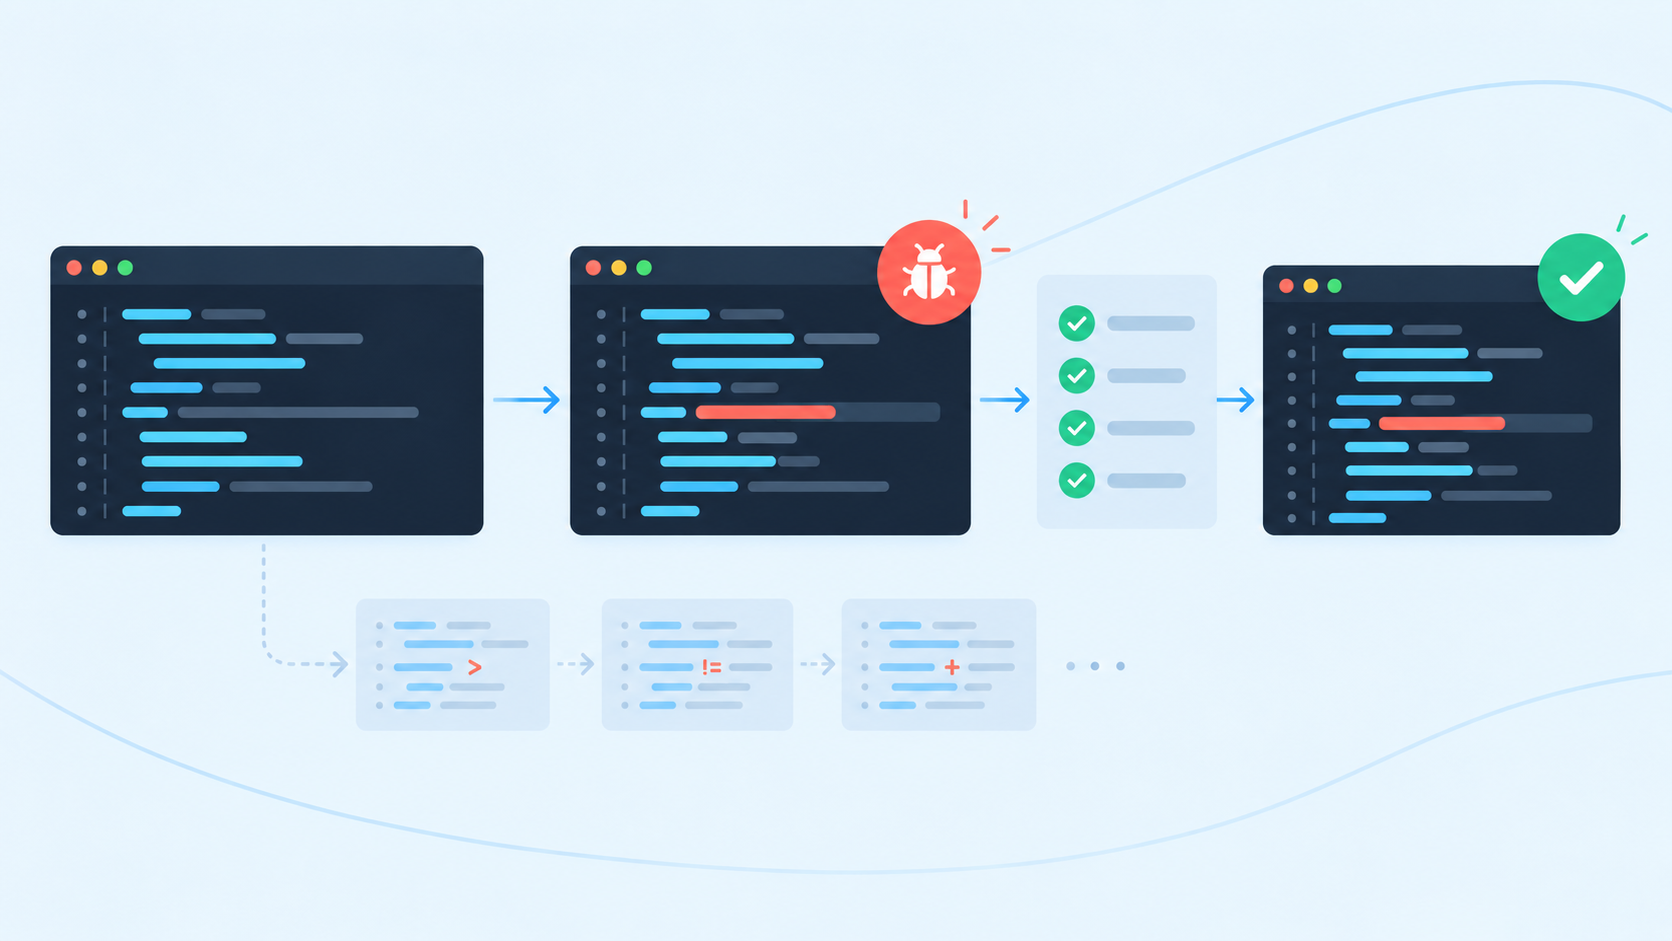
Mutation Testing 자체는 새로운 개념이 아니다.
약 50년 동안 연구되어 온 테스트 기법으로,
기존에는 조건문이나 연산자 등을 정해진 규칙에 따라 변경하면서
현재 테스트가 결함을 얼마나 잘 탐지하는지 평가해왔다.
하지만 여기에는 문제가 있었다.
정해진 규칙으로 수많은 코드를 변경하다 보니
실제로 발생할 가능성이 낮은 결함까지 만들어질 수 있었고,
코드는 달라졌지만 실제 동작에는 변화가 없는
의미 없는 변경도 발생할 수 있었다.
무엇보다 중요한 것은,
수많은 결함 중 우리가 실제로 걱정하는 문제를
어떻게 만들어낼 것인가였다.
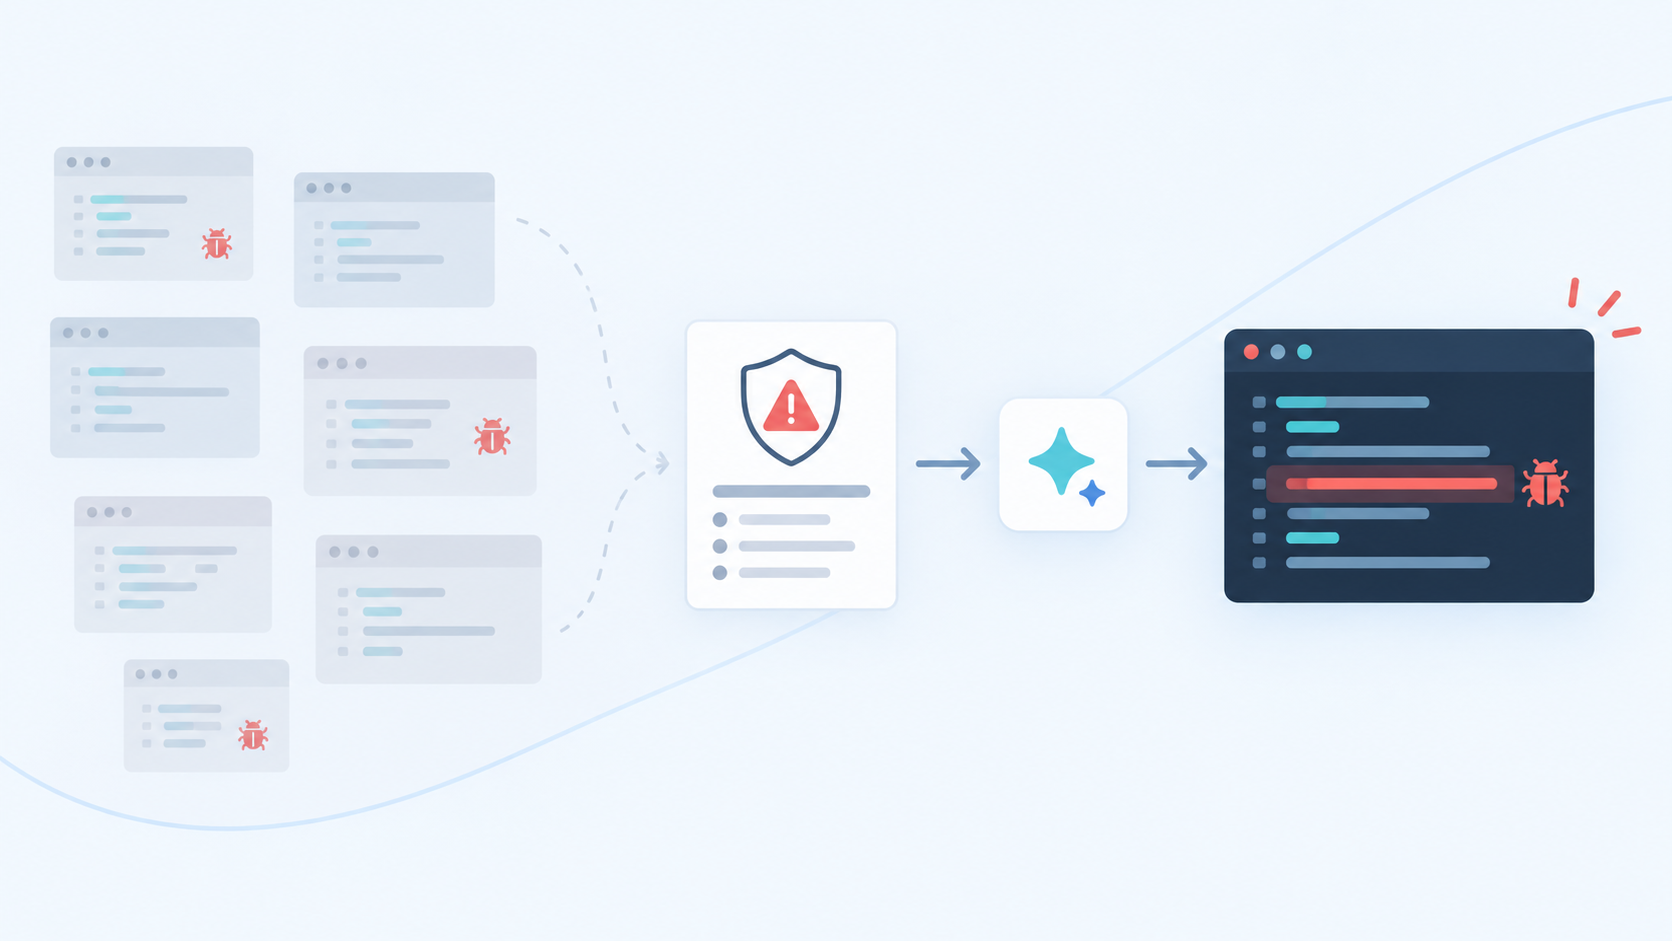
Meta는 이 지점에 LLM을 활용했다.
기존처럼 정해진 규칙으로 무작정 코드를 변경하는 대신,
실제로 우려하는 문제와 관련된 결함을 AI가 만들어내도록 했다.
그리고 그 시작은
AI에게 아무 버그나 만들어달라고 요청하는 것이 아니었다.
2. Meta는 기존 테스트의 빈틈을 어떻게 찾았을까?
1) AI에게 아무 버그나 만들라고 하지 않았다
ACH는 코드에서 무작정 결함을 만드는 것부터 시작하지 않는다.
먼저 정하는 것은
어떤 문제를 막고 싶은가이다.
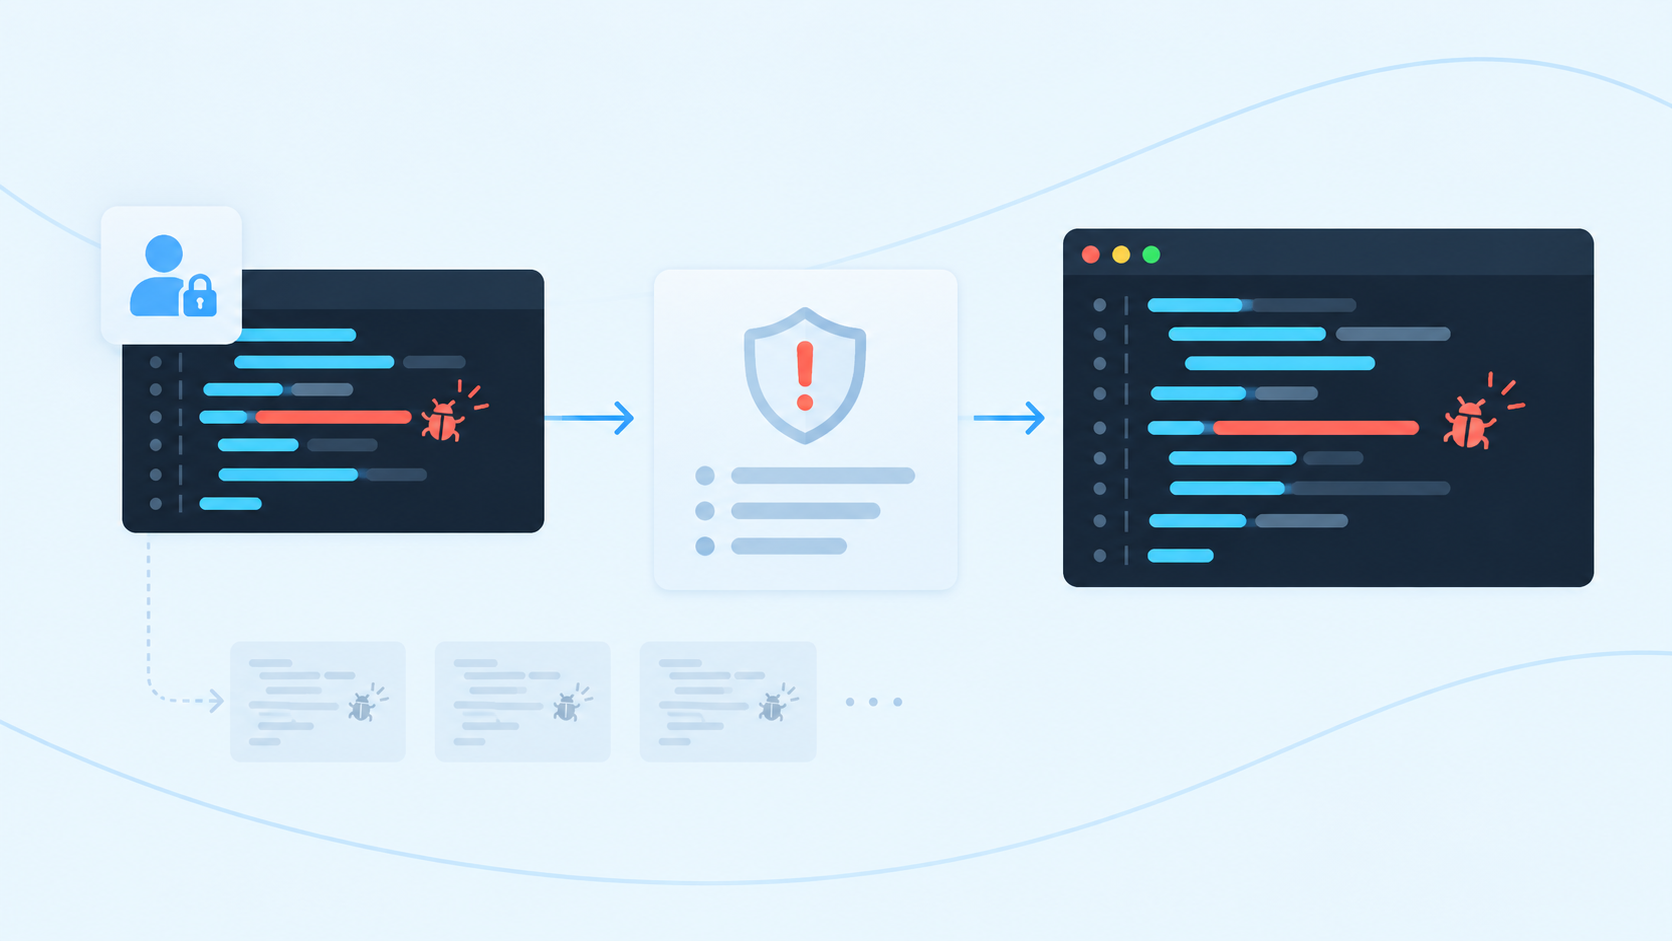
Meta는 이를 Issue of Concern이라고 표현했다.
Concern은 과거에 발생했던 결함이나 요구사항,
기술적 제약, 법률·규제처럼 앞으로 발생하지 않도록 확인해야 할 문제를 의미한다.
Meta는 ACH를 실제 서비스에 적용하면서
주로 과거에 발생했던 Privacy 관련 결함을 활용했다.
한 번 발생했던 문제라면,
비슷한 문제가 다른 코드에서도 다시 발생할 수 있기 때문이다.
ACH는 과거 결함의 코드 변경 내용과 현재 코드를 LLM에 제공하고,
비슷한 유형의 문제가 현재 코드에서도 발생하도록 코드를 변경한다.
이렇게 원본 코드를 의도적으로 변경해 만든 코드를
Mutation Testing에서는 Mutant라고 한다.
과거 실제 결함
→ 어떤 문제가 발생했는지 분석
→ 현재 코드에 유사한 Mutant 생성
즉 AI에게 단순히
“이 코드에 버그를 만들어줘.”
라고 요청하는 것이 아니다.
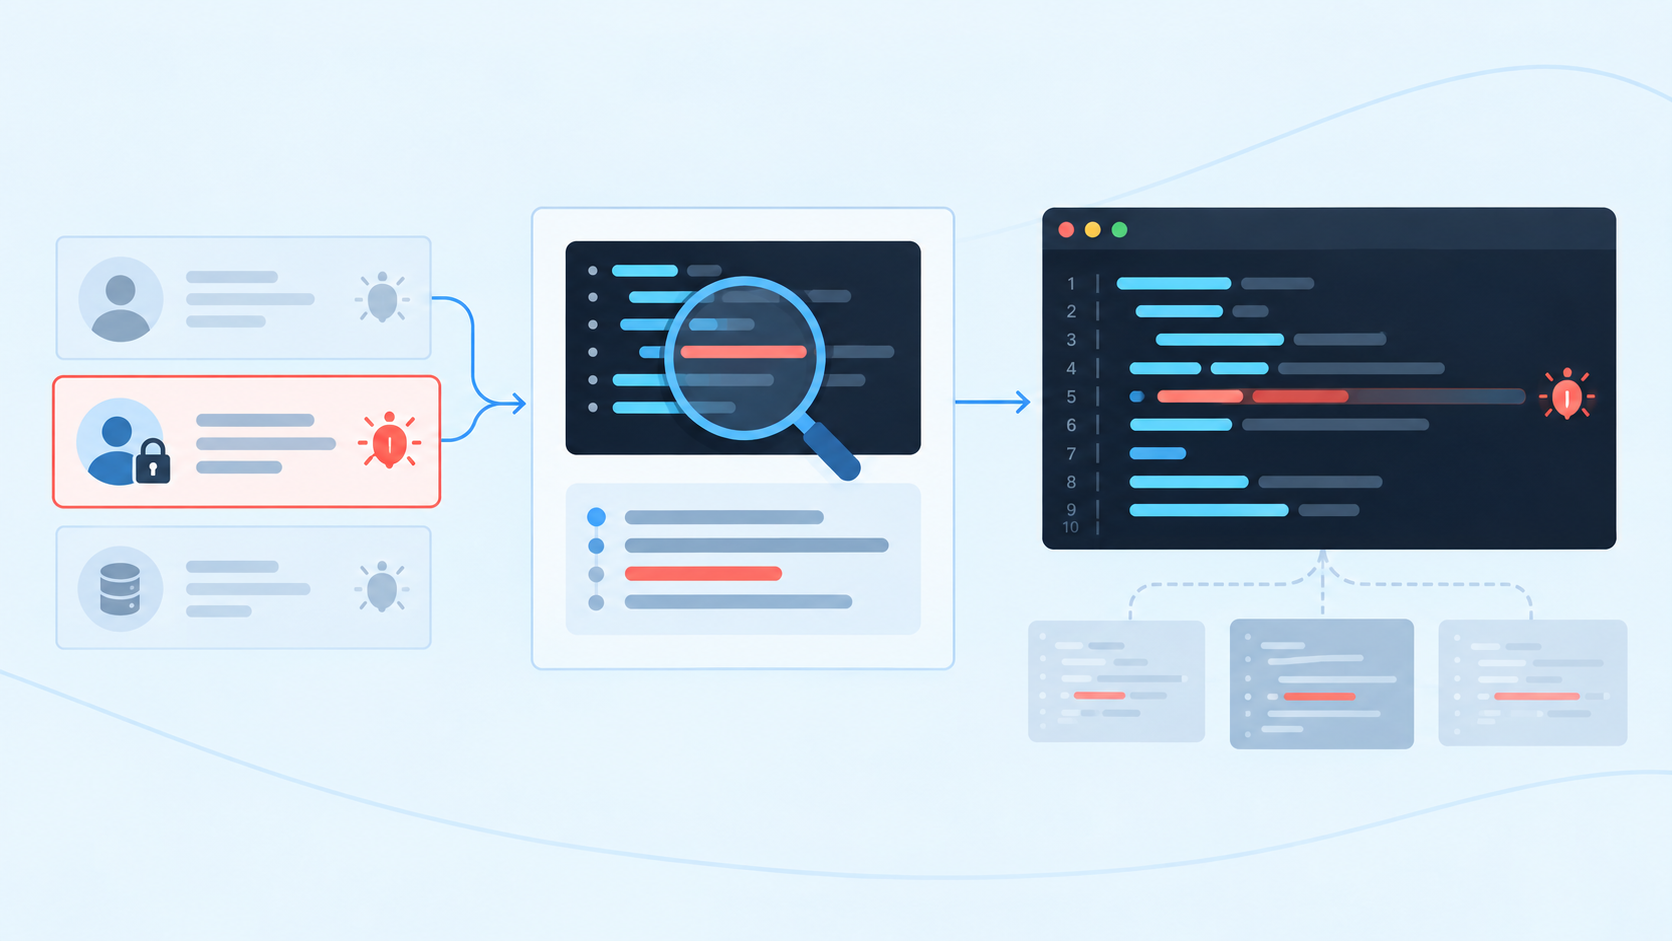
“과거에 이런 문제가 발생했다면,
현재 코드에서는 비슷한 문제가 어떻게 발생할 수 있을까?”
를 만들어보게 하는 것이다.
이를 통해 ACH는 무작위로 많은 결함을 만드는 대신,
실제로 우려하는 문제와 관련된 결함을 중심으로 현재 테스트를 시험한다.
2) AI가 만든 버그가 다 쓸모 있는 것은 아니다
LLM이 Mutant를 만들었다고 해서
바로 새로운 테스트를 만드는 것은 아니다.
먼저 이 결함이 현재 테스트의
실제 빈틈을 보여주는지 확인해야 한다.
가장 먼저 확인하는 것은 코드가 정상적으로 빌드되는가이다.
LLM이 코드를 변경하는 과정에서 문법 오류가 생기거나
애초에 실행할 수 없는 코드가 만들어졌다면 테스트할 의미가 없다.
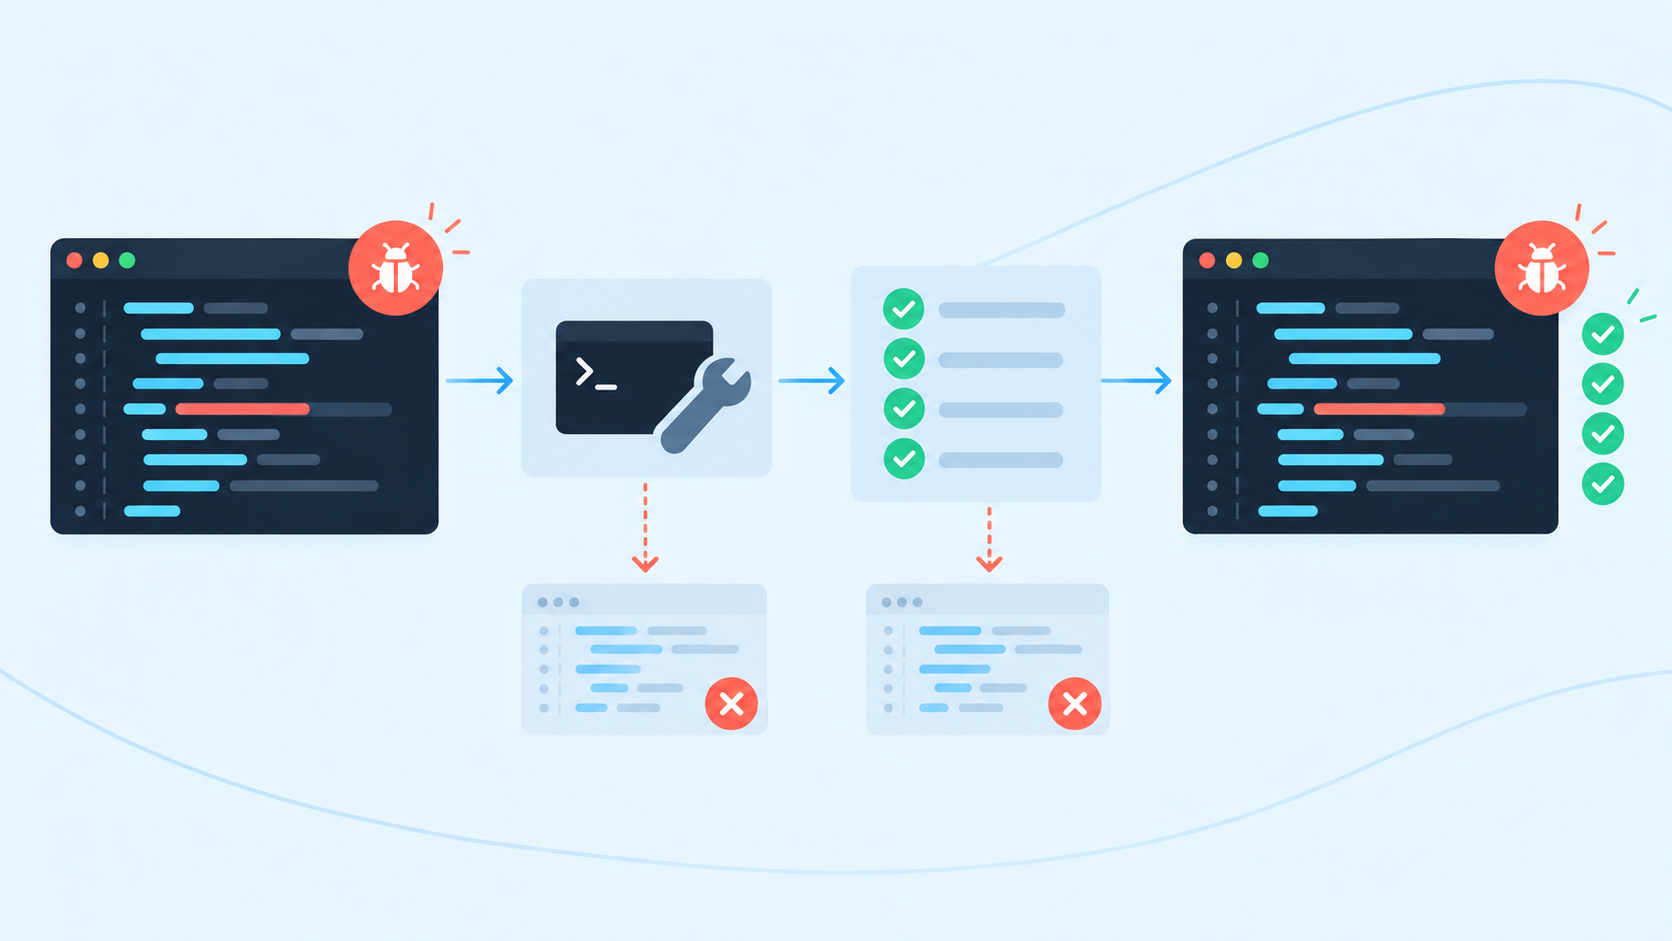
빌드에 성공한 Mutant에는
현재 사용하고 있는 기존 테스트를 그대로 실행한다.
여기서 기존 테스트가 실패한다면
이미 현재 Test Suite가 해당 결함을 발견할 수 있다는 뜻이다.
반대로,
코드에는 결함이 만들어졌는데
기존 테스트는 모두 통과했다.
이 Mutant는 현재 테스트가 잡지 못한 채 살아남은 것(Survived)이다.
즉 ACH가 찾으려는 것은 바로 이런 경우다.
문제가 생겼는데도 테스트가 통과한다면,
현재 검증에 빈틈이 있을 가능성이 있기 때문이다.
하지만 여기서도 바로 새로운 테스트를 만들 수는 없다.
코드가 변경됐다고 해서
실제 동작까지 반드시 달라지는 것은 아니기 때문이다.
이런 Mutant를 Equivalent Mutant라고 한다.
코드는 달라졌다.
하지만 실제 동작은 같다.
이 경우에는 아무리 테스트를 잘 작성해도
원본 코드와 Mutant의 차이를 동작으로 구분할 수 없다.
따라서 “기존 테스트가 잡지 못했다”는 이유만으로
테스트의 빈틈이라고 판단해서는 안 된다.
Meta는 이를 걸러내기 위해
별도의 LLM 기반 Equivalence Detector를 사용했다.
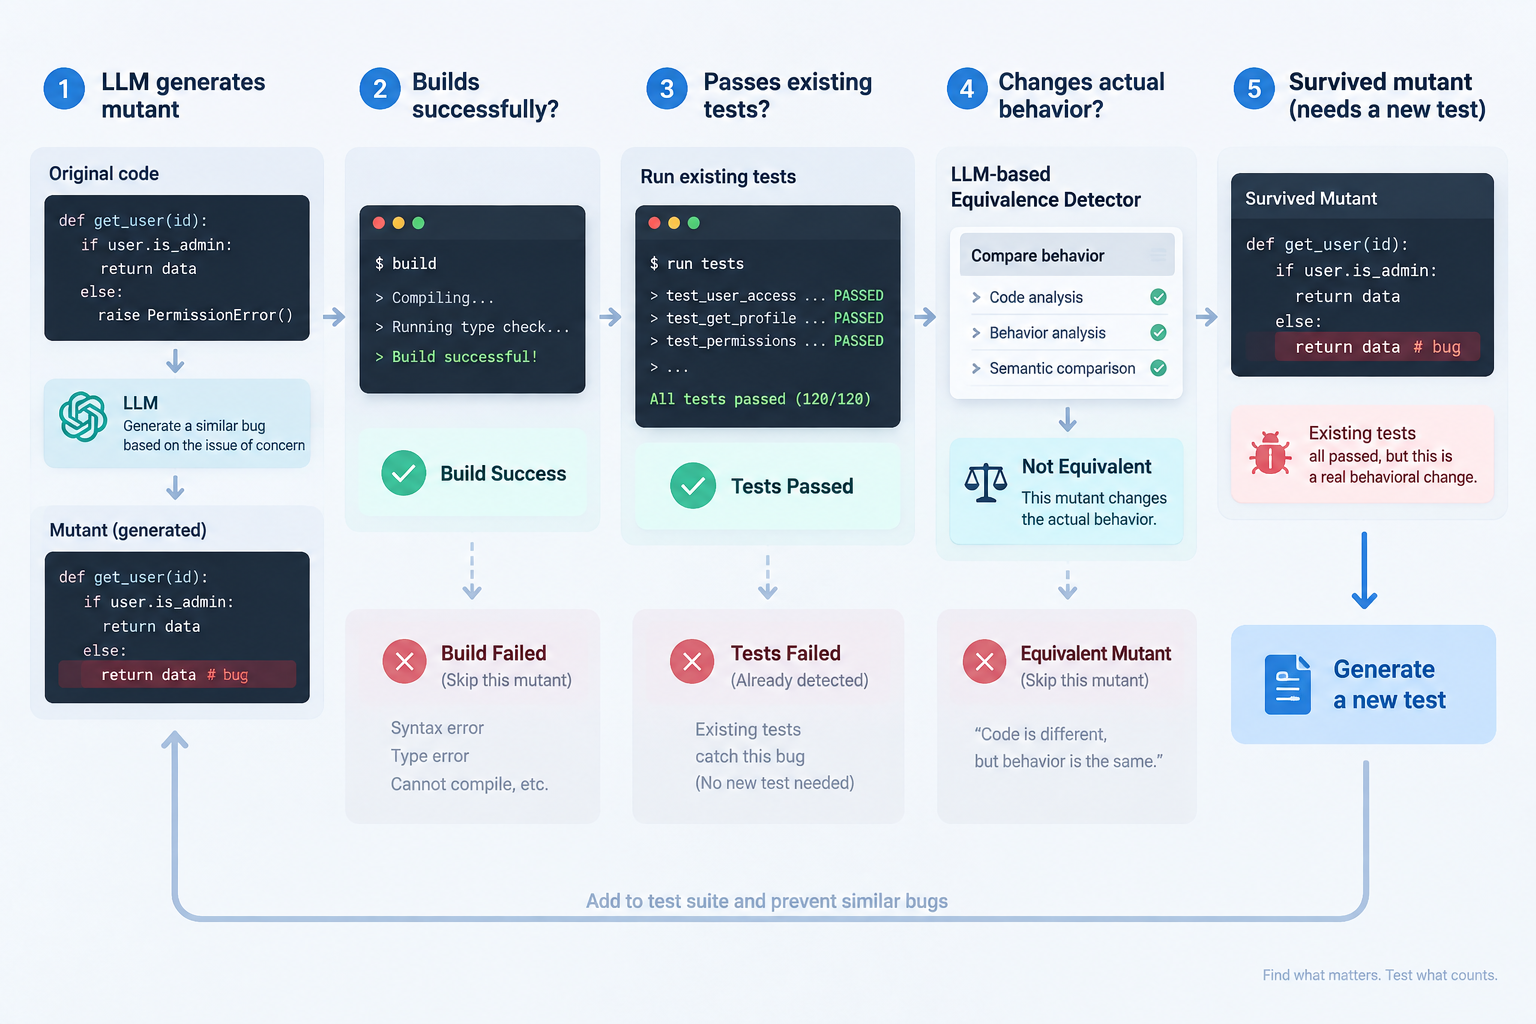
살아남은 Mutant가 실제 동작을 바꾸는 결함인지,
아니면 표현만 달라진 동등한 코드인지를 다시 판별한 것이다.
결국 새로운 테스트가 필요한 후보는
여러 단계를 거치면서 좁혀진다.
LLM이 Mutant 생성
↓
빌드 가능한가?
↓
기존 테스트를 통과하는가?
↓
실제 동작을 바꾸는 결함인가?
↓
현재 테스트가 놓치고 있는 Mutant
이렇게 살아남은 결함이 확인되면,
그제야 ACH는 이를 잡을 새로운 테스트를 만들기 시작한다.
3) 살아남은 버그를 잡는 새로운 테스트를 만든다
앞선 과정을 거쳐 살아남은 Mutant는
기존 테스트가 발견하지 못한 실제 동작의 변화를 보여준다.
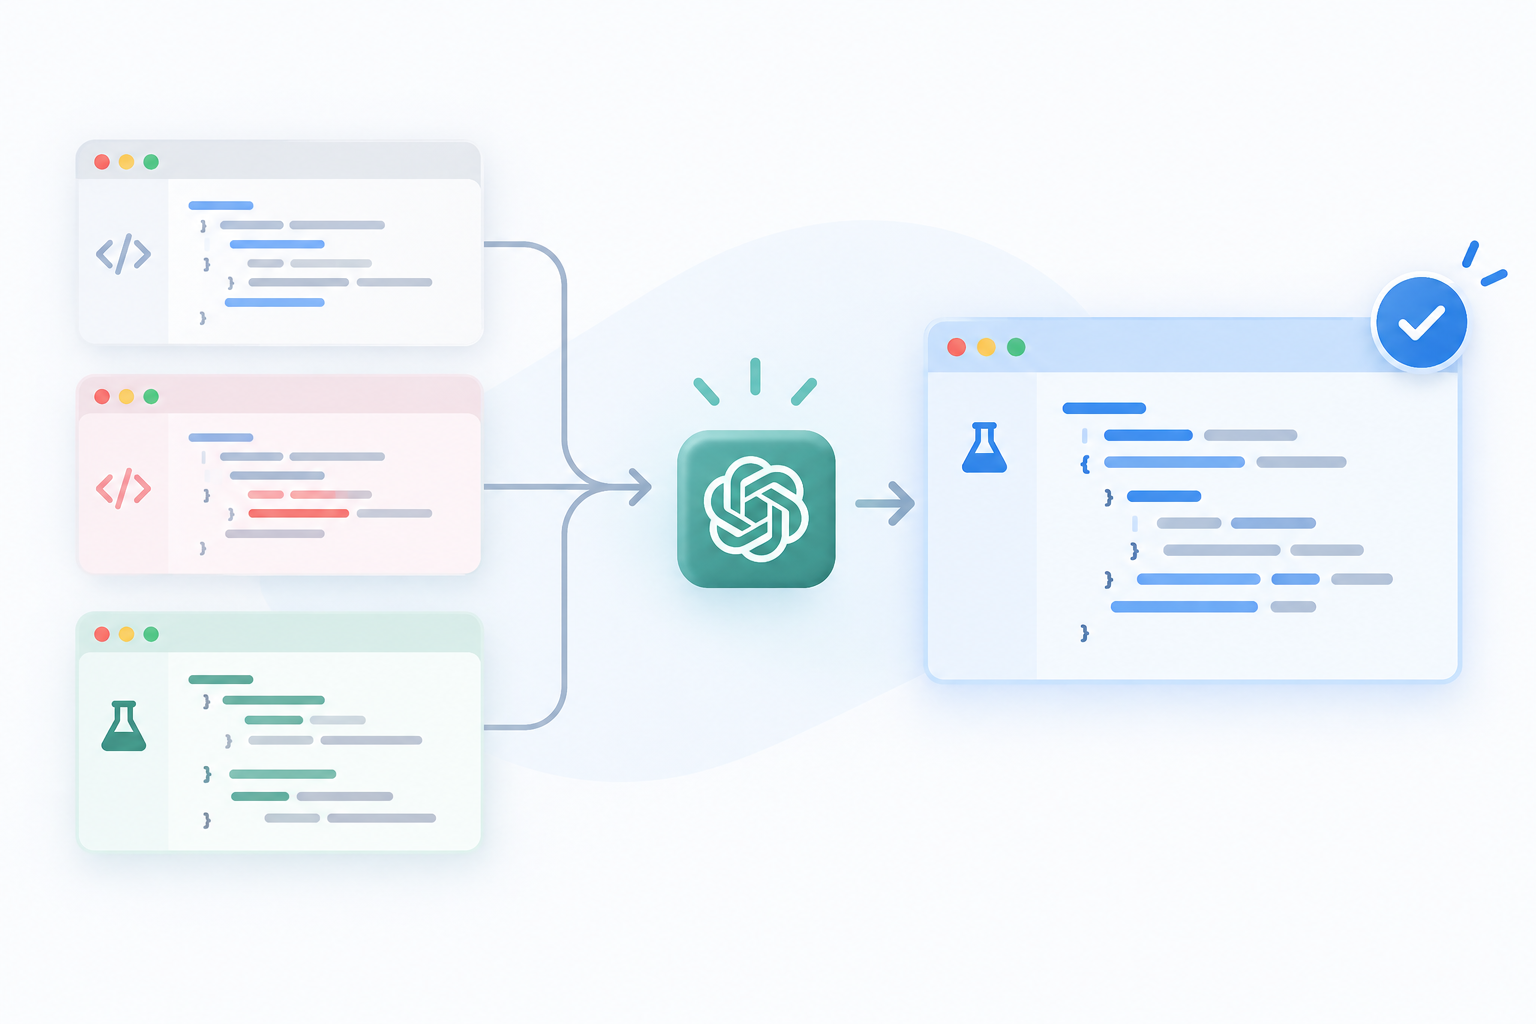
이제 ACH는 이 결함을 잡을 수 있는
새로운 테스트를 LLM으로 생성한다.
이때 LLM에는 원본 코드와 Mutant뿐 아니라
기존에 작성된 테스트도 함께 제공된다.
어떤 코드가 변경됐고,
현재 테스트는 무엇을 확인하고 있는지 참고해
기존 테스트에는 없으면서
해당 Mutant를 발견할 수 있는 테스트를 작성하는 것이다.
하지만 테스트 코드가 만들어졌다고 해서
바로 필요한 테스트가 되는 것은 아니다.
새로운 테스트에는 명확한 조건이 있다.
원본 코드에서는 PASS
Mutant에서는 FAIL
정상적인 코드에서 실패한다면
올바른 동작을 검증하는 테스트라고 보기 어렵다.
반대로 Mutant에서도 통과한다면
처음 발견한 테스트의 빈틈을 메우지 못한 것이다.
정상 동작은 그대로 통과시키면서
기존 테스트가 놓쳤던 결함은 잡아내야 한다.
ACH는 이렇게 결함을 만들어 빈틈을 찾는 것에서 끝나지 않고,
그 빈틈을 메울 새로운 테스트까지 생성한다.
하지만 여기서도 한 가지 문제가 남는다.
AI가 만든 테스트를 그대로 믿어도 될까?
4) AI가 만든 테스트를 다시 테스트한다
새로운 테스트가 만들어졌다고 해서
바로 실제 코드에 적용되는 것은 아니다.
LLM이 만들었다는 이유만으로
결과를 신뢰하지 않는 것이 ACH의 중요한 원칙이다.
Meta는 이를 Assured LLM-based Software Engineering(Assured LLMSE)이라고 설명한다.
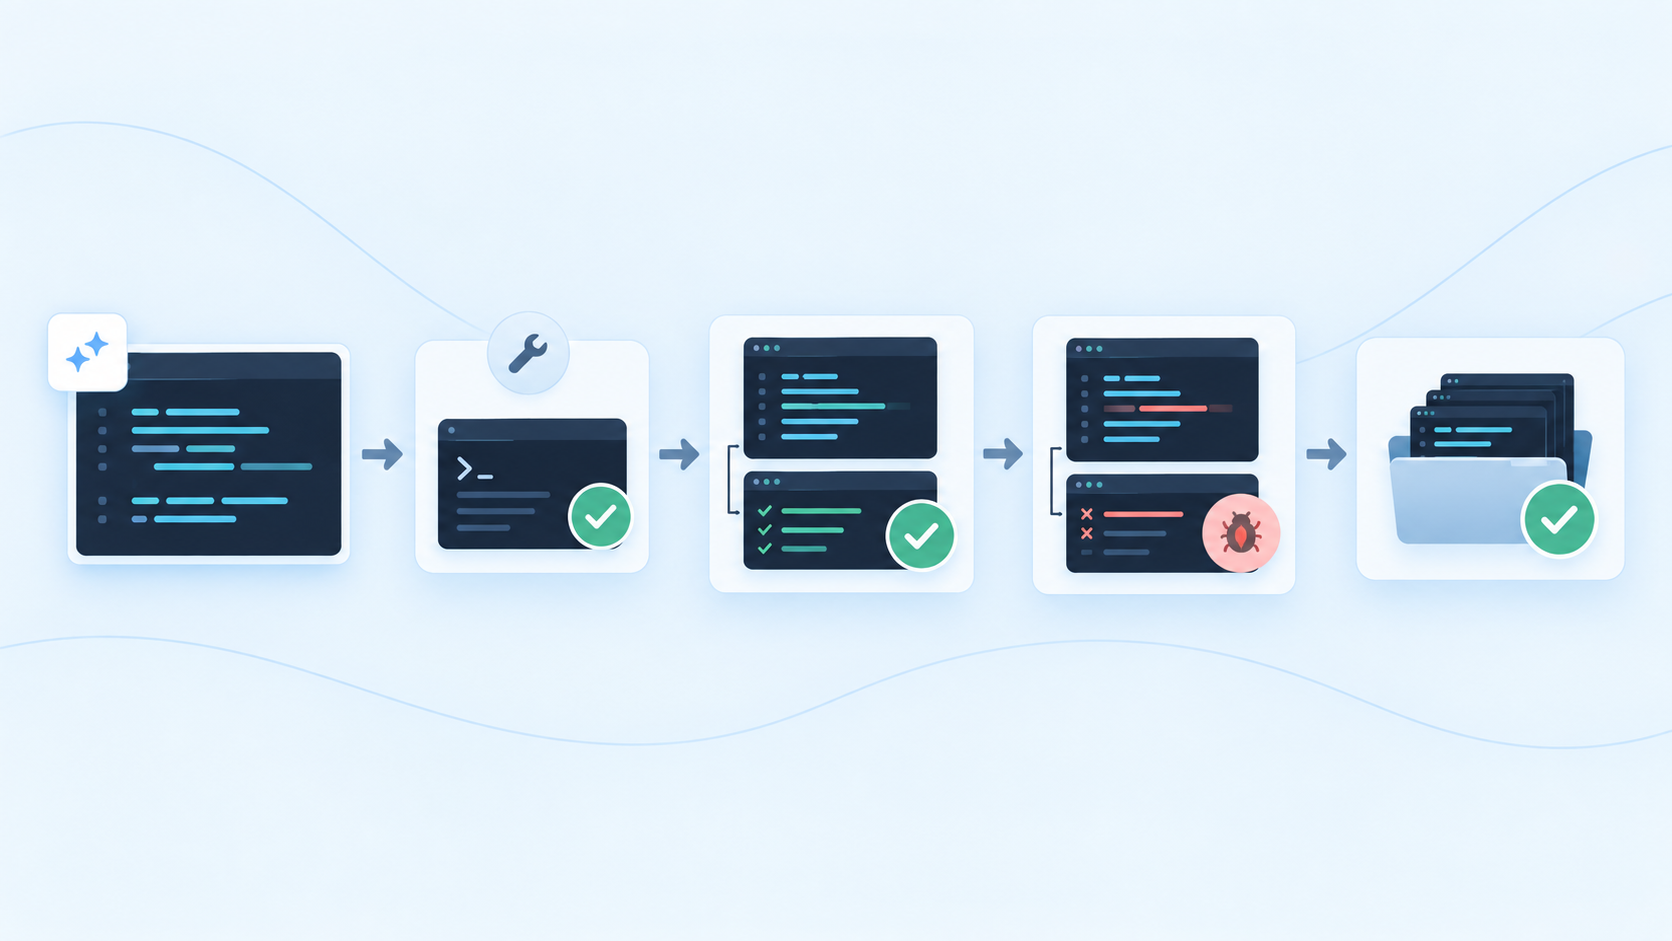
핵심은 간단하다.
AI가 만든 결과 중 직접 확인할 수 있는 것은
실제 실행을 통해 다시 검증한다.
ACH가 생성한 테스트에는 다음과 같은 조건이 적용된다.
Buildable
테스트 코드가 실제로 빌드되는가?Valid Regression Test
정상적인 원본 코드에서 통과하는가?Hardening
목표로 삼은 Mutant를 잡아내는가?
이 조건들은 LLM의 판단에 맡기지 않는다.
직접 코드를 빌드하고 테스트를 실행해 결과로 확인할 수 있기 때문이다.
하지만 테스트가 처음 설정한 Concern과 실제로 관련되어 있는지,
기존 프로젝트의 테스트 방식에 적합한지는
PASS와 FAIL만으로 판단하기 어렵다.
그래서 ACH가 생성한 테스트는
자동으로 코드에 반영되지 않는다.
CI와 Code Review를 거쳐
엔지니어가 테스트의 의미와 필요성을 최종적으로 판단한다.

AI는 테스트를 만들지만,
실제 코드에 들어갈지는 사람이 결정한다.
즉 ACH는 AI의 결과를 그대로 사용하는 자동화가 아니다.
실행으로 검증할 수 있는 것은 자동으로 확인하고,
의미에 대한 판단은 사람에게 남겨두는 구조다.
그렇다면 이렇게 만들어진 테스트는
실제 Meta의 서비스에서도 유용했을까?
3. 실제로 Meta의 테스트는 달라졌을까?
1) 1만 개가 넘는 클래스에 적용해봤다
Meta는 ACH를 연구 단계에서만 검증하지 않았다.
Facebook Feed, Instagram, Messenger, WhatsApp을 비롯한
7개 플랫폼의 실제 코드에 적용했다.
분석 대상은 총 10,795개의 Kotlin 클래스였다.
ACH는 이 코드들을 대상으로 Mutant를 만들고,
앞서 살펴본 과정을 거쳐 실제 테스트의 빈틈을 찾았다.
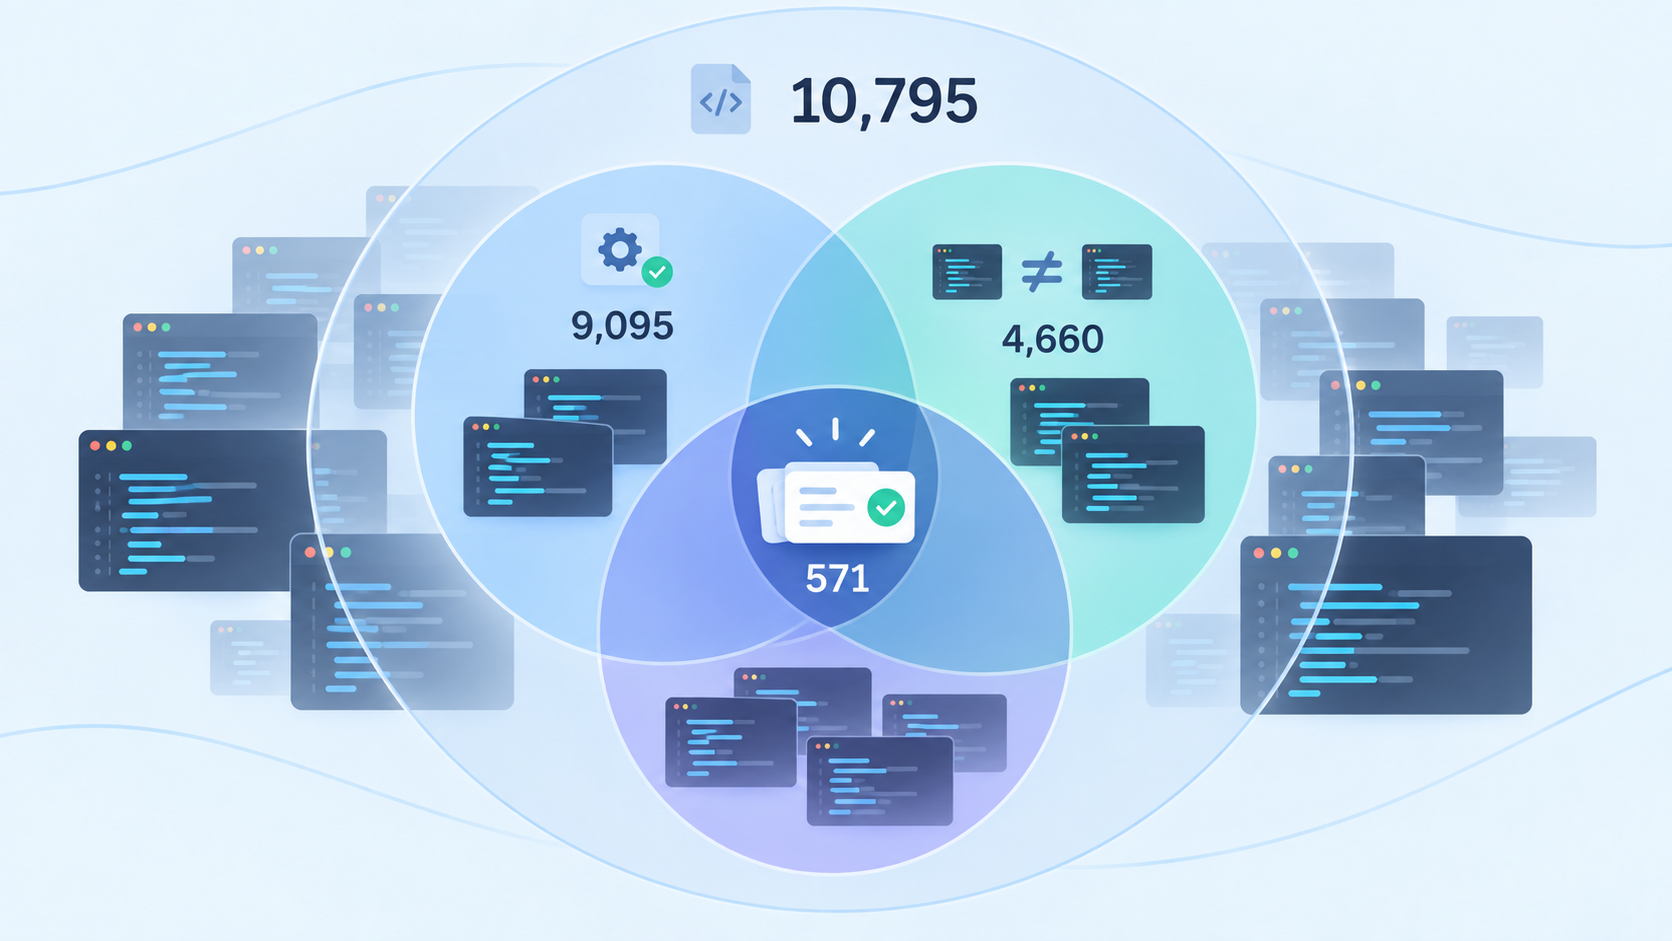
그 과정에서 숫자는 빠르게 줄어들었다.
분석한 Kotlin 클래스
10,795개↓
빌드되고 기존 테스트를 통과한 Mutant
9,095개↓
동등하지 않은 것으로 판단된 Mutant
4,660개↓
최종 생성된 테스트
571개
많은 Mutant를 만드는 것 자체가 목적은 아니었다.
빌드할 수 없는 변경이나 기존 테스트가 이미 잡는 결함,
실제 동작을 바꾸지 않는 Mutant를 걸러내고
새로운 검증이 필요한 경우에 테스트를 생성한 것이다.
그렇다고 이 571개의 테스트가
모두 자동으로 실제 코드에 반영된 것도 아니다.
앞서 살펴본 것처럼 최종적으로는
Meta 엔지니어가 생성된 테스트를 직접 검토했다.
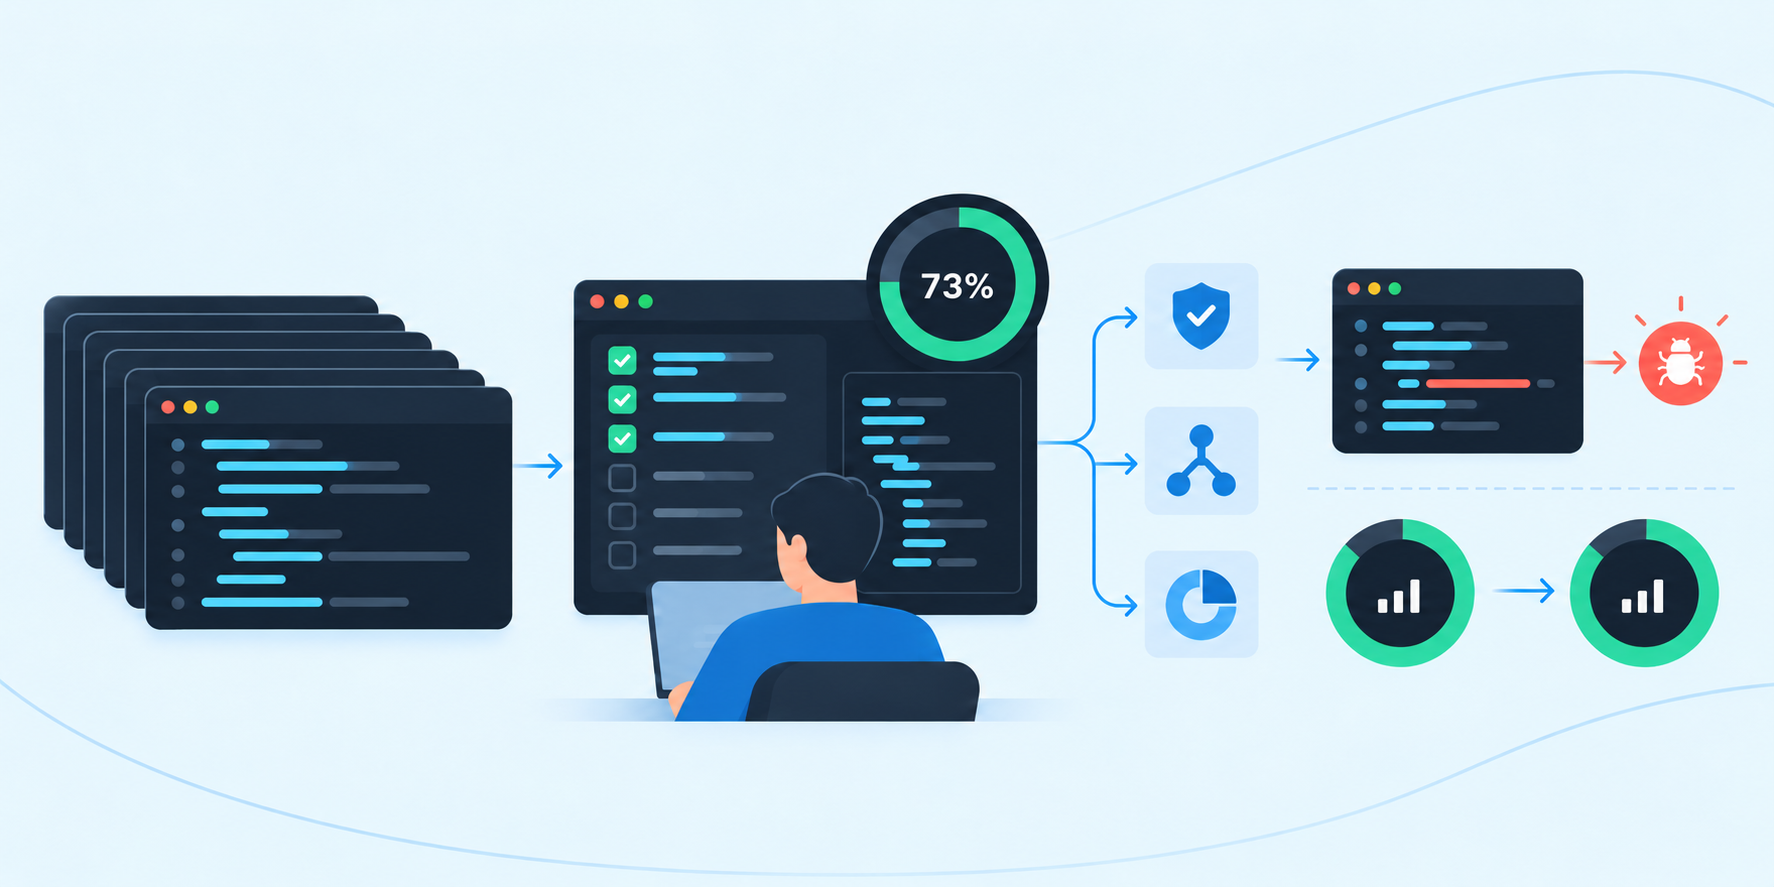
그 결과, ACH가 제안한 테스트의 73%를
엔지니어가 유용한 테스트로 받아들였다.
처음 ACH가 주로 다루려 했던 것은 Privacy와 관련된 문제였다.
하지만 실제 검토에서는 Privacy와 직접 관련되지 않은 테스트도
기존 테스트가 놓치던 Corner Case나 Coverage를 보완한다는 이유로 받아들여졌다.
즉 ACH가 만들어낸 테스트는 단순히 실행 가능한 코드에 그치지 않고,
실제 개발자가 기존 Test Suite에 추가할 가치가 있다고 판단한 경우가 상당수 있었다.
그리고 이 결과에서 더 흥미로운 점이 하나 있었다.
새로운 테스트가 버그를 더 잘 잡았다고 해서
항상 Coverage까지 높아진 것은 아니었다.
2) 커버리지가 늘지 않아도 버그는 더 잘 잡을 수 있었다
앞에서 한 가지 흥미로운 결과를 먼저 살펴봤다.
ACH가 생성한 테스트 가운데 약 49%는
Line Coverage를 높이지 않았다.
새로운 테스트를 추가했는데도
실행되는 코드의 범위는 이전과 달라지지 않았다는 뜻이다.
그렇다면 이 테스트들은
기존 테스트와 별다른 차이가 없었던 걸까?

그렇지 않았다.
Coverage는 늘어나지 않았지만,
기존 테스트가 놓쳤던 Mutant를 새롭게 잡아냈다.
이유는 앞에서 살펴본 것처럼
코드를 실행하는 것과 그 동작을 제대로 검증하는 것은 다르기 때문이다.
기존 테스트가 이미 특정 코드를 실행하고 있다면
같은 코드를 대상으로 새로운 조건을 검증해도 Line Coverage는 올라가지 않을 수 있다.
하지만 그 새로운 테스트가
기존에는 확인하지 않았던 동작의 변화를 잡아낸다면,
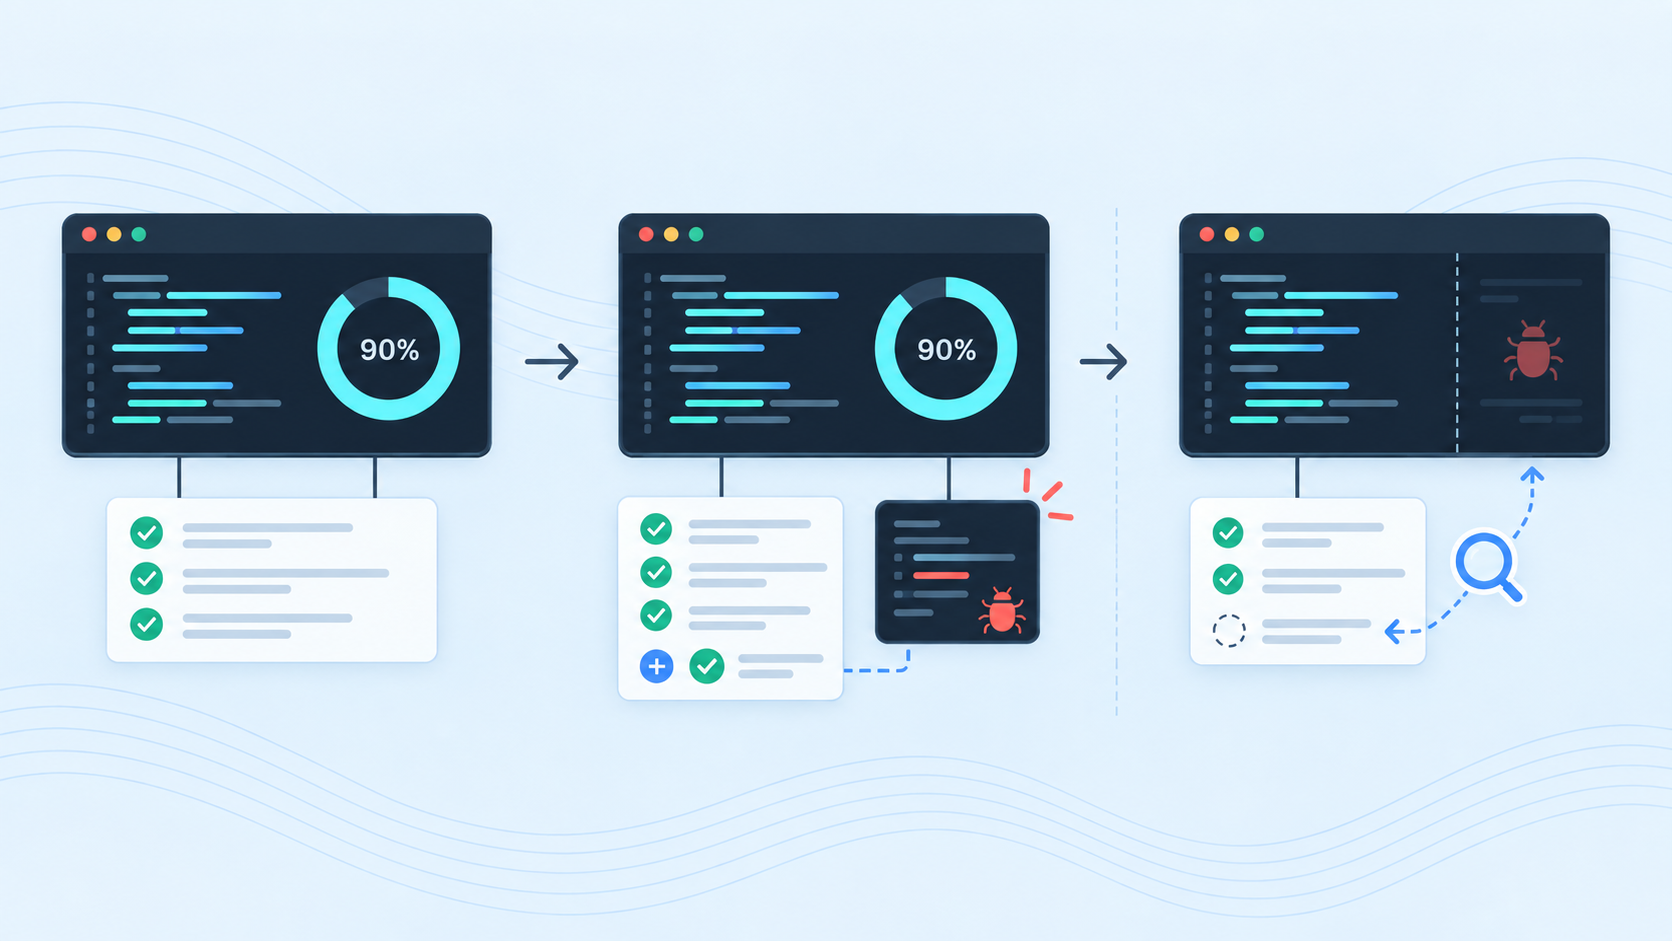
실행 범위는 그대로여도
결함을 탐지하는 능력은 달라질 수 있다.
Coverage
얼마나 많은 코드를 실행했는가?
Mutation Testing
실제로 결함이 생겼을 때 잡아낼 수 있는가?
Meta의 결과는 이 두 질문이 같지 않다는 것을 보여준다.
그렇다고 Coverage가 필요 없다는 의미는 아니다.
Coverage는 아직 테스트되지 않은 코드가 어디인지 확인하는 데 유용하고,
Mutation Testing은 이미 테스트하고 있는 코드에서도 실제 결함을 잡을 수 있는지 확인하는 데 도움이 된다.
ACH는 이 차이를 이용해
Coverage만으로는 드러나지 않던 테스트의 빈틈을 찾아냈다.
하지만 여기서 ACH의 역할을 정확히 구분할 필요가 있다.
ACH가 현재 코드에 숨어 있는 버그를
직접 찾아낸 것은 아니기 때문이다.
3) AI가 실제 버그를 찾아주는 시스템은 아니다
여기까지 보면 ACH가
AI로 실제 버그를 찾아내는 시스템처럼 보일 수도 있다.
하지만 ACH의 목적은 조금 다르다.
현재 코드에 숨어 있는 버그를 찾는 것이 아니라,
앞으로 발생할 수 있는 문제에 대비해 테스트를 강화하는 것이다.
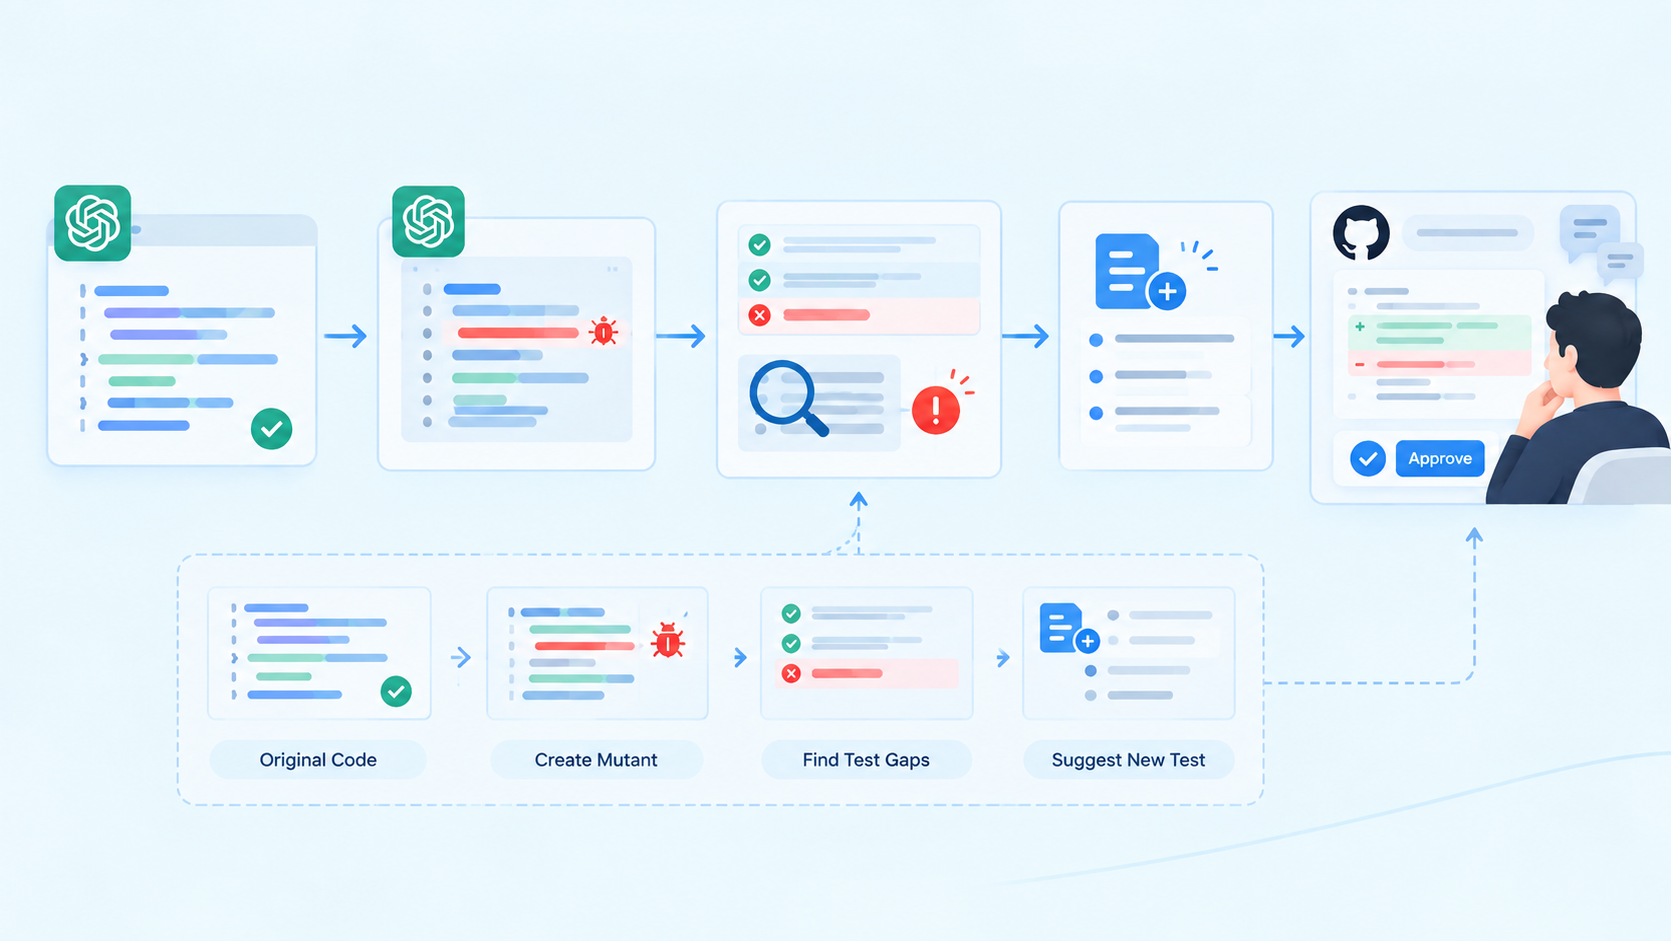
ACH는 기본적으로 현재 코드를 정상 상태로 두고 시작한다.
그리고 과거에 발생했던 결함이나 Concern을 바탕으로
현재 코드에 의도적으로 새로운 결함을 만든다.
기존 테스트가 이를 잡지 못하면
해당 문제를 검증할 새로운 테스트를 추가한다.
즉 ACH가 찾는 것은 현재 코드의 버그 자체가 아니라,
버그가 생겼을 때 놓칠 수 있는 테스트의 빈틈에 가깝다.
물론 모든 과정을 AI에게 맡길 수 있는 것도 아니다.
LLM이 만든 Mutant가 처음 의도한 Concern을
정확하게 반영하지 못할 수도 있고,
생성된 테스트가 실제 프로젝트에서 필요한지 역시
실행 결과만으로 판단하기 어렵다.
그래서 Meta 역시 최종 단계에서는
엔지니어의 Code Review를 통해 테스트의 관련성과 필요성을 확인했다.
AI가 결함을 만들고, 테스트의 빈틈을 찾고,
필요한 테스트까지 제안한다.
하지만 무엇을 실제 테스트로 남길지는 사람이 결정한다.
흥미로운 점은 이렇게 만들어진 테스트의 약 절반이
Line Coverage를 더 높이지 않았다는 것이다.
더 많은 코드를 실행하지 않아도
기존에는 확인하지 못했던 문제를 새롭게 검증할 수 있었다.
결국 Meta가 AI를 활용한 지점은
단순히 테스트 코드를 더 빠르게 만드는 데 있지 않았다.
현재 테스트가 무엇을 놓치고 있는지 찾아내고,
새로 만든 검증이 정말 필요한지 다시 확인하는 것.
AI가 테스트에 들어오는 방식은 달라지고 있지만,
무엇을 검증해야 하는지 찾고 그 결과를 확인하는 과정은 여전히 남아 있다.
'QA Insight > 품질 사례·트렌드' 카테고리의 다른 글
| 2026 QA 자동화 솔루션 현황 (0) | 2026.09.14 |
|---|---|
| 2026 QA 테스트 도구·툴 현황 (0) | 2026.09.14 |
| 2026 국내 QA(품질보증) 아웃소싱 업체 현황 (0) | 2026.09.14 |
| 변화하는 UI를 따라가는 LinkedIn의 AI 테스트 자동화 (0) | 2026.09.03 |
| 매일 학습, 매주 배포 — 글로벌 서비스 듀오링고의 AI 테스트 자동화 방법 (0) | 2026.08.28 |