AI 코딩 도구를 활용하면서
코드를 만드는 데 걸리는 시간은 점점 줄어들고 있다.새로운 기능을 더 빠르게 만들고,
기존 코드도 더 빠르게 수정할 수 있게 됐다.그렇다면 테스트도 그만큼 빨라졌을까?
Duolingo의 사례를 통해 개발 방식이 빨라지는 환경에서 검증 방식은 어떻게 달라져야 하는지 살펴본다.
오히려 더 많은 코드가 더 빠르게 만들어진다면
검증해야 할 대상 역시 빠르게 늘어난다.
듀오링고의 iOS 팀도 이 문제를 마주했다.
매주 새로운 버전을 배포하는 환경에서
늘어나는 코드를 개발 속도에 맞춰 어떻게 검증할 수 있을까?
Duolingo는 그 답을
단순히 테스트를 더 많이 실행하는 데서 찾지 않았다.
무엇을 테스트할지 찾고, 테스트 코드를 만드는 과정부터 AI로 자동화하기 시작했다.
[목차]
1. 글로벌 서비스 듀오링고의 AI 테스트 자동화
1) 매주 새 버전을 배포하면 테스트는 어떻게 따라갈까?
Duolingo의 iOS 팀은 매주 새로운 버전을 배포한다.
새로운 기능이 추가되고 기존 기능이 수정되면서 코드베이스 역시 매주 달라진다.
여기에 AI 코딩 도구가 들어오면서
제품 코드를 작성하고 수정하는 속도는 더 빨라졌다.
문제는 코드가 만들어진 다음이다.
기능 하나가 추가되면
그 기능이 정상적으로 동작하는지만 확인하면 되는 것은 아니다.
변경된 코드가 기존 동작에 영향을 주지는 않는지,
예상한 조건과 예외 상황에서도 같은 결과를 보이는지 확인해야 한다.
그리고 이런 검증을 반복 가능하게 만들기 위해 단위 테스트를 작성한다.
하지만 기능 구현이 빨라졌다고 해서
테스트까지 함께 만들어지는 것은 아니다.
테스트할 대상을 정하고,
코드의 의존성을 파악하고,
필요한 테스트를 작성해 실제 프로젝트에서 동작하는지 확인하는 과정은 별도로 남는다.
코드 생산 속도가 빨라질수록
이 작업은 점점 뒤에 쌓이기 시작한다.
개발 속도를 높였더니,
그다음 단계인 검증이 속도를 따라가지 못하기 시작한 것이다.
Duolingo가 해결해야 했던 것은
테스트를 몇 번 더 실행하는 문제가 아니었다.
계속해서 늘어나는 코드만큼
필요한 테스트를 어떻게 만들어낼 것인가.
문제는 테스트가 실행되는 순간보다 그 앞에 있었다.
2) 병목은 테스트 실행이 아니라 테스트 코드 작성이었다
테스트 자동화라고 하면 보통
이미 작성된 테스트를 자동으로 실행하는 과정을 떠올린다.
코드가 변경되면 CI가 실행되고,
미리 작성해둔 테스트를 반복해서 수행한다.
문제가 없다면 통과하고,
기존 동작이 깨졌다면 실패한다.
하지만 여기에는 전제가 하나 있다.
실행할 테스트가 이미 작성되어 있어야 한다.
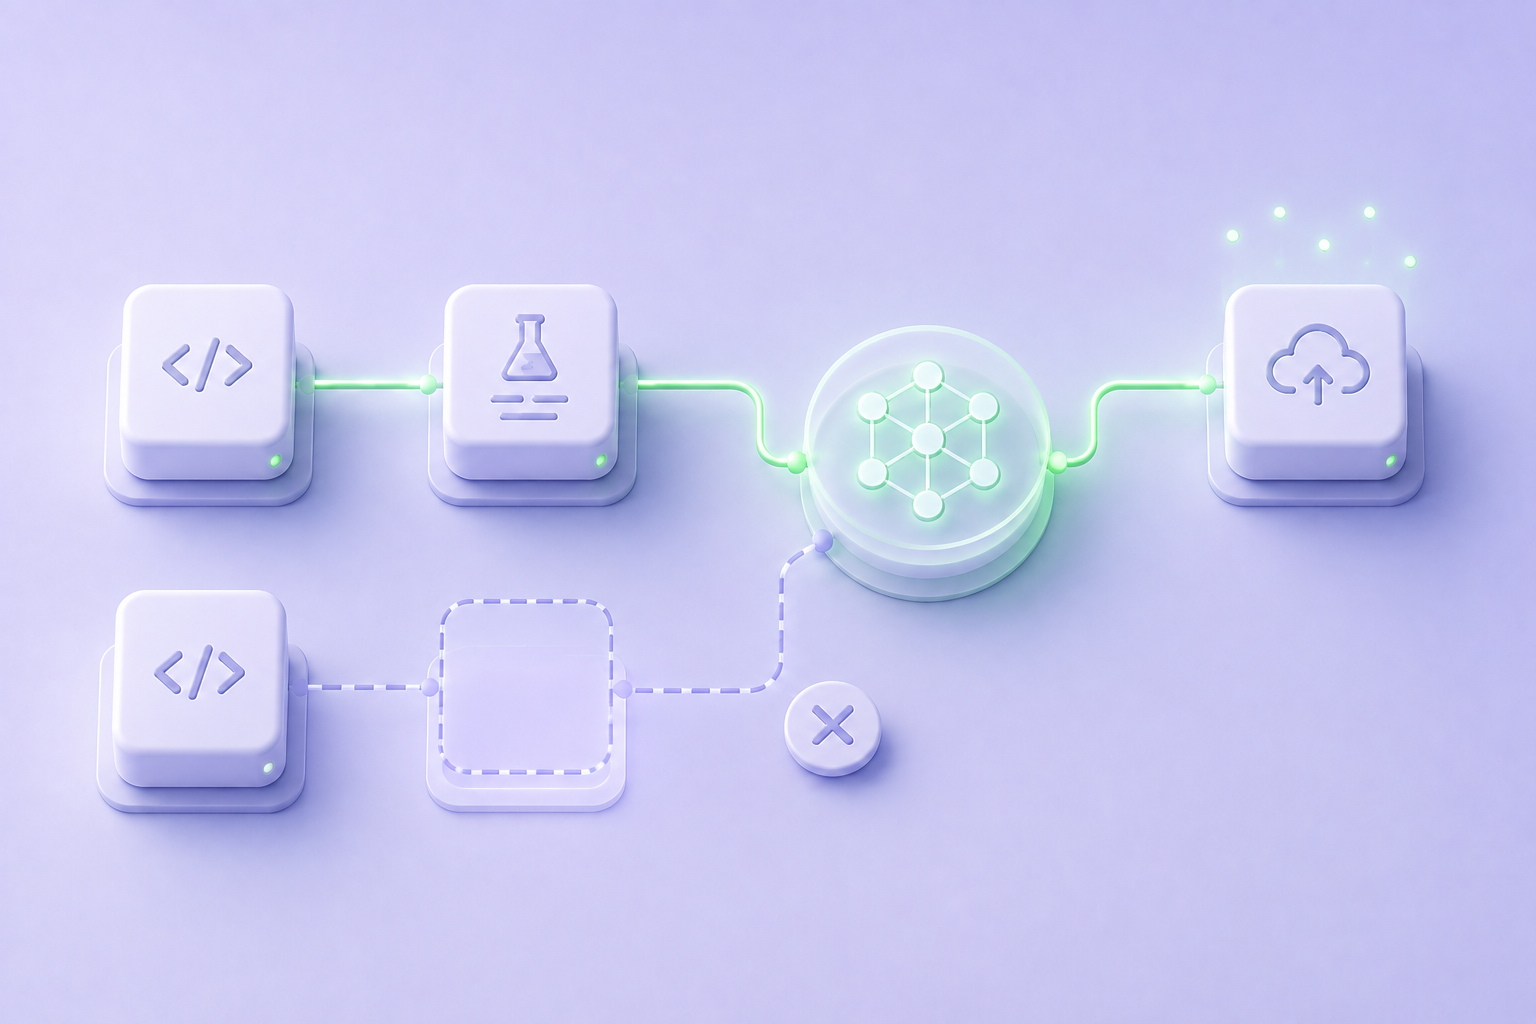
새로운 코드가 추가되면 상황이 달라진다.
어디에 테스트가 부족한지 찾고,
어떤 코드를 테스트할지 정한 뒤
대상 코드의 의존성을 파악해야 한다.
필요하다면 Mock이나 Fake를 만들고 테스트 코드를 작성한다.
CI에서 실패하면 원인을 찾아 다시 수정해야 한다.
테스트가 부족한 코드 탐색
→ 테스트 대상 선정
→ 의존성 분석
→ Mock/Fake 구성
→ 테스트 코드 작성
→ CI 실행
→ 실패 시 수정
Duolingo가 자동화하려 한 것은 바로 이 과정이었다.
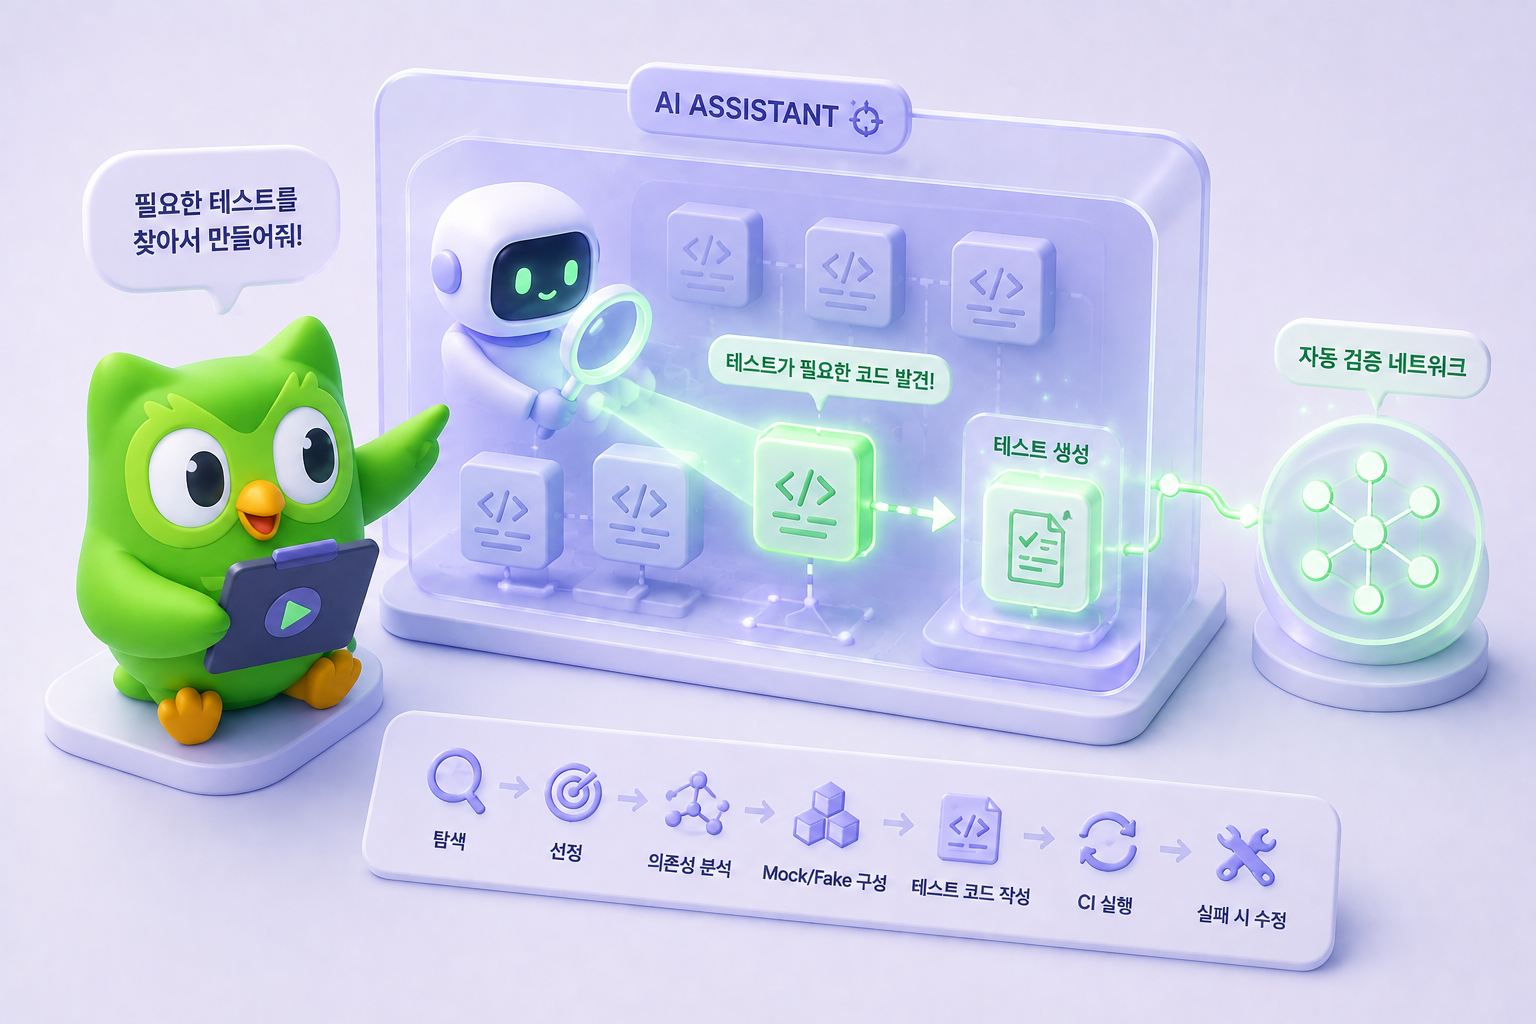
사람이 만들어둔 테스트를 반복해서 실행하는 데서 그치지 않고,
필요한 테스트를 찾아 실제 코드로 만들어내는 과정까지 자동화의 대상으로 넓혔다.
그렇다면 테스트를 작성하기 전에 먼저 해결해야 할 문제가 있다.
수많은 코드 중 어디에 테스트를 추가할 것인가?
2. AI는 테스트를 어떻게 만들었을까?
1) 어떤 코드를 테스트할지 먼저 결정한다
모든 코드에 테스트가 필요한 것은 아니다.
테스트가 부족하더라도 우선순위가 낮을 수 있고,
반대로 테스트를 추가했을 때 효과가 큰 코드도 있다.
Duolingo는 이를 판단하기 위해 Xcode Code Coverage 데이터를 활용했다.
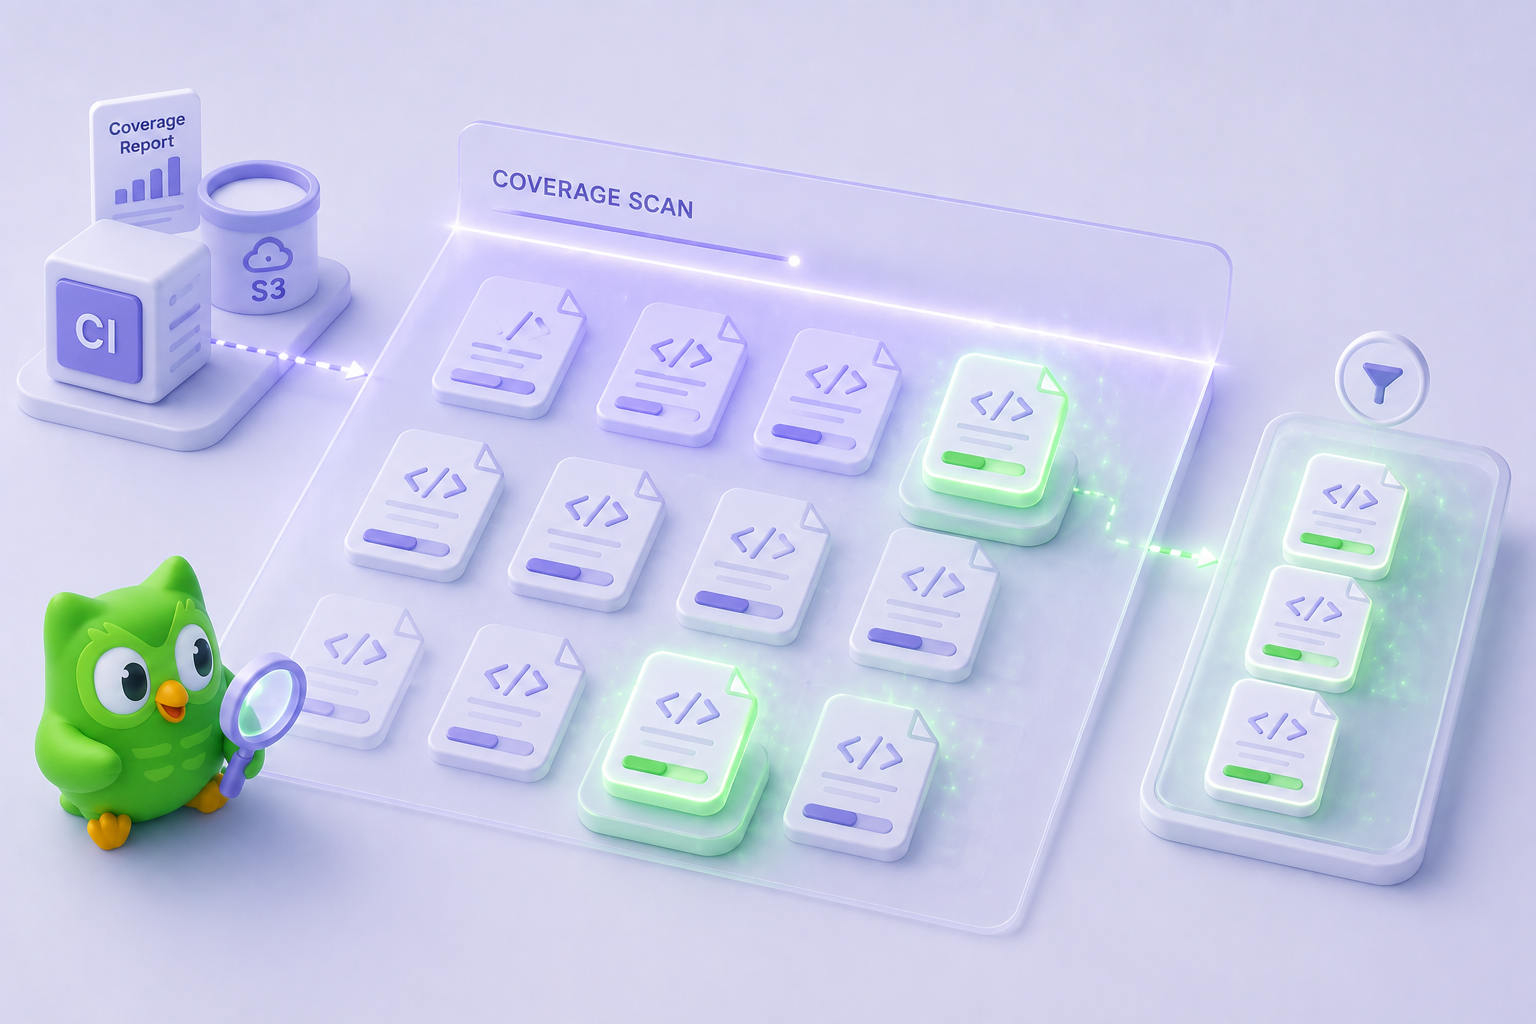
코드가 main 브랜치에 병합되면 CI가 최신 Coverage 리포트를 생성하고,
그 결과를 S3에 저장한다.
파이프라인은 이 데이터를 가져와
테스트가 부족한 Swift 파일을 찾는다.
여기서 단순히 커버리지가 낮은 파일부터 Claude Code에 맡기지는 않았다.
Duolingo는 네 가지 신호를 조합해 각 파일의 우선순위를 계산했다.
| 판단 기준 | 가중치 | 기준 |
| 파일 타입 | 2.5× | ViewModel·Repository 등 MVVM 패턴의 파일을 우선 |
| Coverage Gap | 0.5× | 테스트되지 않은 라인이 많을수록 높은 점수 |
| 파일 크기 | -0.3× | 상대적으로 작은 파일을 우선 |
| 모듈 우선순위 | 0.5× | Feature·Legacy 라이브러리를 Core보다 우선 |
눈에 띄는 것은 파일 타입에 가장 높은 가중치를 줬다는 점이다.
단순히 테스트되지 않은 코드가 많은 파일을 고른 것이 아니라,
ViewModel이나 Repository처럼 역할과 구조가 명확해
AI가 테스트를 작성하기 적합한 코드인지도 함께 고려했다.
즉 Duolingo는 테스트가 얼마나 부족한지와
AI가 테스트를 만들기에 얼마나 적합한지를 함께 보고 작업 대상을 정했다.
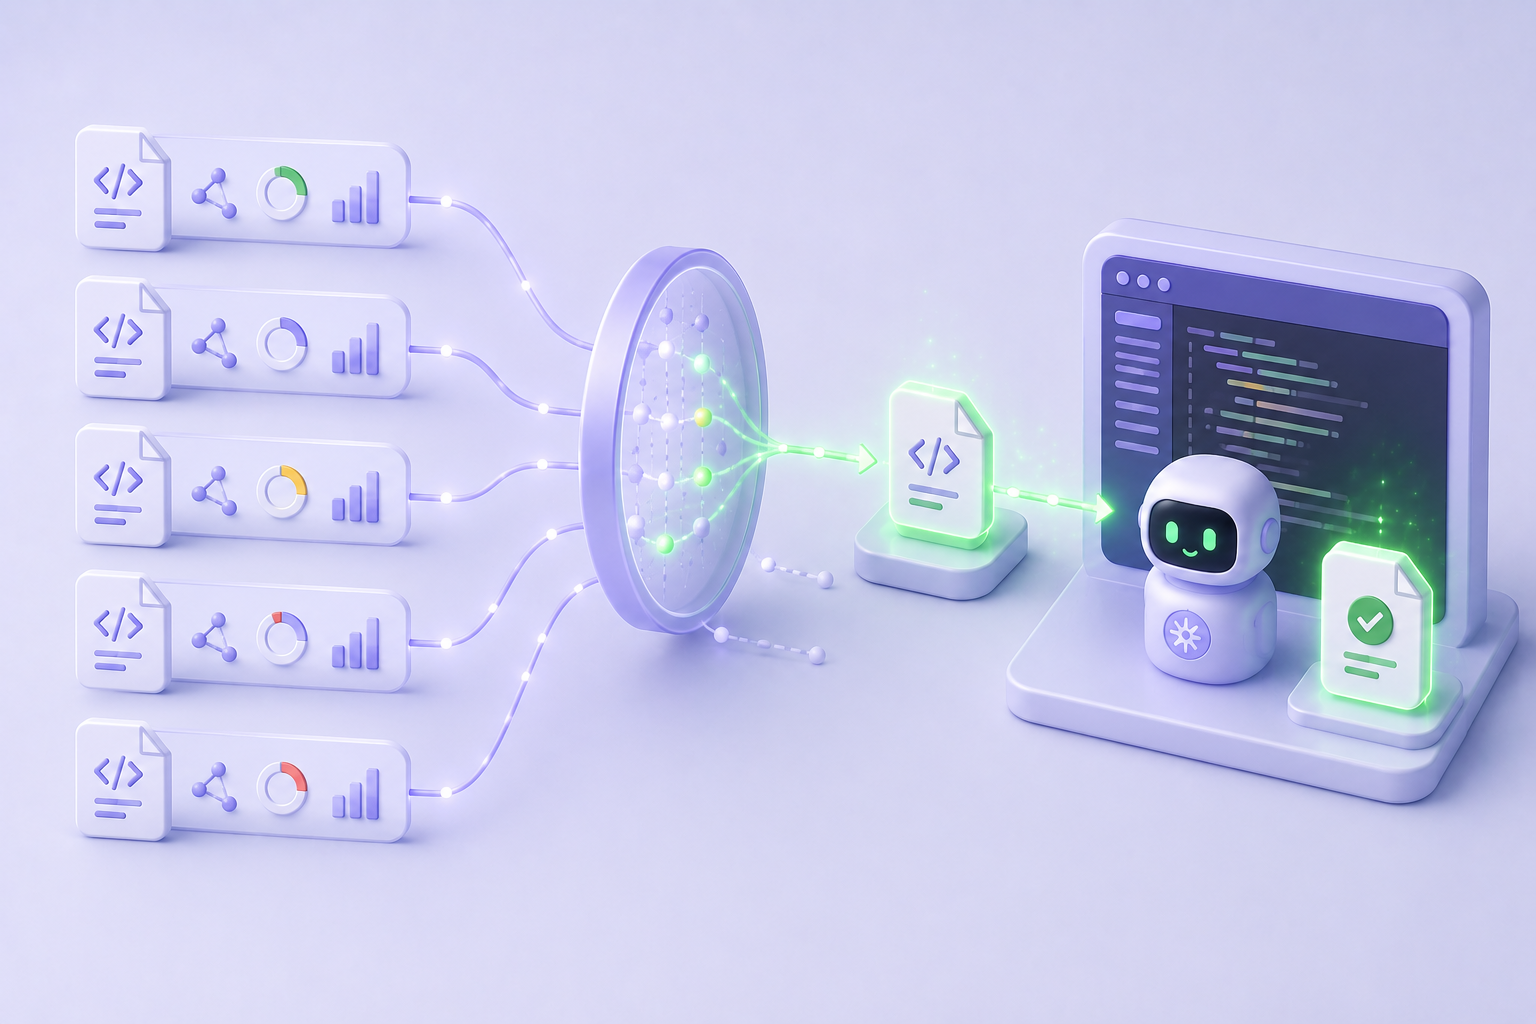
덕분에 Claude Code가 전체 코드베이스에서 직접 할 일을 찾을 필요도 없었다.
시스템이 먼저 대상을 좁히고,
AI는 선택된 파일의 테스트 작성에 집중한다.
테스트를 생성하기 전에,
무엇을 테스트할 것인지부터 자동화한 것이다.
이렇게 선택된 파일은 바로 Claude Code로 넘어가지 않는다.
실제 테스트 생성을 시작하기 전에
중복 작업이나 이전 실패 여부 등을 한 번 더 확인한다.
2) 테스트 생성 파이프라인은 어떻게 움직일까
우선순위가 정해진 파일은 테스트 생성 전에 한 번 더 걸러진다.
이미 같은 파일을 대상으로 열린 PR이 있거나,
*Tests.swift 파일이 존재하면 대상에서 제외한다.
이전에 테스트 생성을 시도했다가 실패한 파일에는
30일 Cooldown을 적용해 반복 작업도 막는다.
이 조건을 통과하면 실제 테스트 생성 workflow가 시작된다.
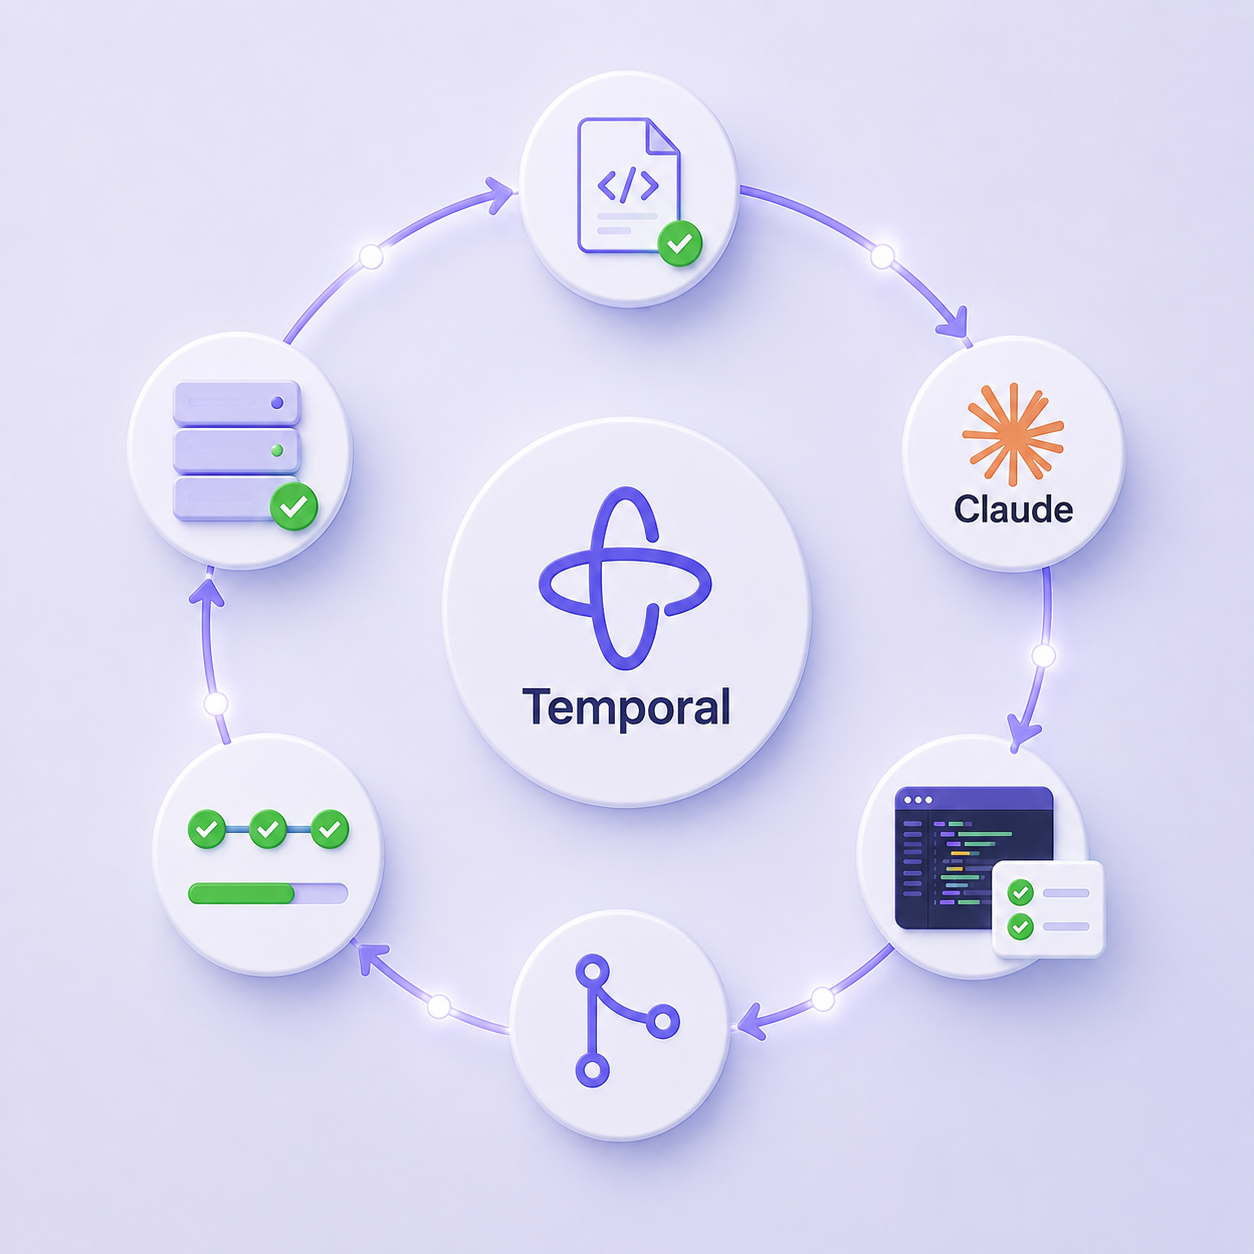
전체 흐름을 연결하고 관리하기 위해 Temporal이라는 워크플로 관리 도구를 사용했다.
Temporal을 중심으로 대상 파일을 Claude Code에 전달하고,
테스트를 생성해 PR을 만든 뒤 CI로 검증하는 과정을 하나의 lifecycle로 연결했다.
이 workflow에 들어오는 경로는 두 가지다.
두 가지 테스트 생성 경로
첫 번째는 Backfill이다.
기존 코드베이스의 Coverage 데이터를 바탕으로
테스트가 부족한 파일을 찾아 지속적으로 테스트를 보강한다.
두 번째는 Label Trigger다.
개발자가 자신의 PR에 trigger:write-tests 라벨을 붙이면
해당 변경 사항을 대상으로 테스트 생성을 요청할 수 있다.
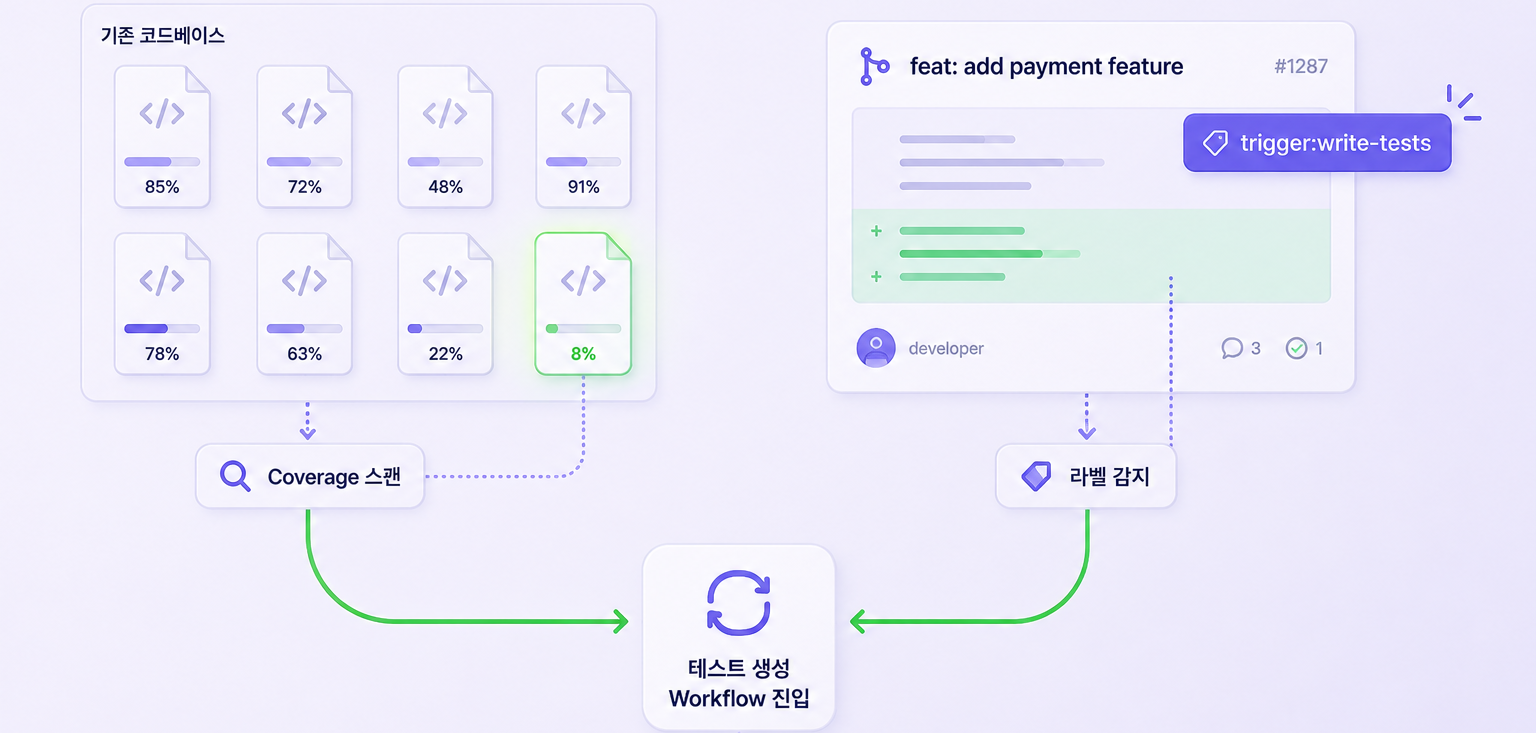
즉 하나는 기존 코드에 남아 있는 테스트 공백을 채우고,
다른 하나는 새롭게 작성되는 코드에 대응한다.
진입 방식은 다르지만 이후 과정은 같다.
테스트할 Swift 파일이 정해지면 Claude Code 세션을 실행한다.
Claude Code는 기존 코드와 테스트 패턴을 참고해
필요한 테스트와 Mock/Fake 객체를 작성하고 PR을 생성한다.
이 PR은 다시 CI를 통해 검증된다.
전체 구조를 연결하면 다음과 같다.
Xcode Coverage → S3 → 대상 스코어링 → 필터링 → Temporal → Claude Code → 테스트 생성 → PR → CI
여기서 Claude Code는 전체 자동화 시스템의 한 단계다.
그 앞에서는 어떤 코드를 테스트할지 결정하고,
그 뒤에서는 생성된 테스트가 실제로 동작하는지 검증한다.
3) AI는 실제 프로젝트에서 동작하는 테스트를 어떻게 만들었을까
테스트할 파일이 정해졌다고 해서
몇 줄의 테스트 코드를 생성하는 것으로 끝나지는 않는다.
실제 프로젝트에 들어갈 테스트라면
대상 코드가 어떤 구조로 작성되어 있고 무엇에 의존하는지 이해해야 한다.
예를 들어 어떤 기능이 서버 응답에 따라 다르게 동작한다면,
정상 응답과 오류 상황을 각각 만들어 결과를 확인해야 한다.
이때 실제 서버를 호출하는 대신
원하는 상황을 만들어주는 테스트용 객체인 Mock이나 Fake를 사용한다.
Duolingo의 iOS 프로젝트는 MVVM(Model-View-ViewModel) 구조를 사용한다.
Claude Code는 대상 파일만 보고 일반적인 테스트를 생성하는 것이 아니라,
주변 코드와 기존 테스트를 함께 살펴보면서 프로젝트의 방식을 참고했다.
비슷한 기능을 어떤 조건에서 테스트하는지,
Mock이나 Fake를 어떻게 구성하는지 파악한 뒤
대상 코드에 필요한 테스트를 작성했다.
대상 코드 분석 → 기존 테스트 패턴 확인 → 필요한 테스트와 Mock/Fake 생성
여기에는 기존 코드의 구조도 영향을 미친다.
특정 기능이 외부 객체와 강하게 연결되어 있다면
테스트에서 원하는 상황으로 바꿔가며 확인하기 어려워진다.
즉 테스트하기 어려운 코드는 AI에게도 테스트하기 어렵다.
Duolingo가 앞선 단계에서 구조와 역할이 명확한 코드를 우선한 이유도 여기에 있다.
결국 중요한 것은 테스트 코드를 얼마나 많이 생성할 수 있느냐가 아니었다.
기존 프로젝트의 구조와 테스트 방식을 따라
실제로 사용할 수 있는 테스트를 만들 수 있느냐가 더 중요했다.
4) CI가 실패하면 AI는 어디까지 다시 시도할까
Claude Code가 테스트를 만들었다고 해서
그 코드가 바로 사용 가능한 것은 아니다.
생성된 코드는 기본적인 사전 검증을 거친 뒤 PR로 만들어지고,
CI에서 실제 프로젝트와 함께 검증된다.
약 17주 동안 병합된 테스트 PR 가운데
76%는 첫 번째 시도에서 CI를 통과했다.
그렇다면 나머지는 어떻게 처리했을까?

CI가 실패하면 오류 로그를 다시 Claude Code에 전달했다.
Claude Code는 실패 원인을 분석하고 코드를 수정한 뒤 커밋하고,
CI는 수정된 코드를 다시 검증한다.
CI 실패 → 로그 분석 → 코드 수정 → 재검증
이 과정은 최대 5회까지 반복됐다.
그래도 해결되지 않으면 PR을 종료하고,
같은 파일을 곧바로 다시 시도하지 않도록 30일 Cooldown을 적용했다.
성공할 때까지 AI에게 계속 수정을 맡긴 것이 아니라,
재시도 횟수와 포기 조건까지 자동화 흐름 안에 넣은 것이다.
AI가 직접 확인할 수 없는 것도 있었다
여기에는 실행 환경의 한계도 있었다.
테스트 생성 작업을 수행하는 Temporal 워커는 Linux 환경에서 동작했기 때문에,
iOS 코드를 PR 생성 전에 직접 컴파일하거나 검사하는 데 제약이 있었다.
그 결과 일부 문제는 CI에 도달한 뒤에야 발견됐다.
별도로 공개된 최근 배치에서는 13.6%의 실패율이 나타났고,
대부분 코드 작성 규칙을 검사하는 SwiftLint 위반과 관련돼 있었다.
이 13.6%는 앞서 나온 76%와 같은 집계의 나머지 값은 아니다.
- 76%: 약 17주 동안 병합된 PR의 첫 CI 통과율
- 13.6%: 별도의 최근 배치에서 관찰된 실패율
Duolingo는 이를 남아 있는 과제로 보고
Mac 환경에서 생성된 코드를 더 일찍 검증하는 방안도 계획하고 있다.
이 사례에서 확인할 수 있는 한계는 분명하다.
AI가 코드를 생성하고 수정할 수 있다는 것과,
그 코드가 실제 환경에서 동작하는지 검증할 수 있다는 것은 다른 문제다.
3. 실제 운영에서는 무엇이 달라졌을까?
1) Duolingo는 처음부터 AI에게 모든 것을 맡기지 않았다
Duolingo는 처음부터 Claude Code를 자동화 파이프라인에 연결하지 않았다.
본격적인 자동화에 앞서 몇 주 동안 Claude Code를 직접 실행하며
어떤 테스트를 만들고, 어디에서 실패하는지 먼저 관찰했다.
자동화 전에 먼저 실패를 관찰했다

생성된 테스트와 CI 결과를 사람이 확인하면서
반복되는 실패 유형도 드러났다.
Mock 타입이 맞지 않거나 Swift 6 규칙을 지키지 못하는 경우도 있었고,
기존 코드 구조 때문에 테스트용 객체로 교체하기 어려운 경우도 있었다.
앞서 살펴본 것처럼
테스트하기 어려운 코드는 AI에게도 테스트하기 어려웠다.
Duolingo는 이런 문제를 확인하면서 일부 기존 코드의 구조를 개선하고,
안정적으로 수행할 수 있다고 판단한 작업부터 자동화에 포함시켰다.
즉 AI에게 곧바로 전체 과정을 맡긴 것이 아니라,
실패를 먼저 관찰하고 자동화할 수 있는 범위를 찾아간 것이다.
자동화 이후에도 사람이 필요했던 이유
파이프라인을 구축한 뒤에도 AI에게 모든 수정 권한을 맡기지는 않았다.
실제로 CI 실패를 수정하는 과정에서
Claude Code가 테스트 파일이 아닌 실제 서비스 코드를 수정한 사례도 있었다.
AI 입장에서는 오류를 해결하기 위한 수정이었지만,
테스트를 작성한다는 원래 작업 범위를 벗어난 것이다.
자동으로 실패를 분석하고 수정할 수 있다는 것은
그만큼 어디까지 수정하도록 허용할 것인지도 함께 정해야 한다는 의미였다.
그래서 최종 판단은 사람에게 남겨뒀다.
약 17주 동안 이 파이프라인을 통해 생성된
250개의 PR은 모두 병합 전에 사람 엔지니어의 리뷰와 승인을 거쳤다.
AI는 테스트를 작성하고,
실패하면 원인을 분석해 다시 수정할 수 있었다.
하지만 그 결과를 실제 코드베이스에 반영할지 결정하는 역할은 사람이 담당했다.
자동화의 범위를 넓히는 것과
사람의 판단을 없애는 것은 같은 문제가 아니었다.
2) 17주 동안 실제로 무엇이 달라졌을까
Duolingo는 이 파이프라인을 약 17주 동안 운영했다.
그동안 250개의 테스트 PR이 병합됐고, 85,000줄 이상의 테스트 코드가 추가됐다.
생성된 테스트 함수는 4,460개로,
총 233개 클래스에 새로운 테스트가 추가됐다.
결과는 실제 테스트 범위의 변화로도 이어졌다.
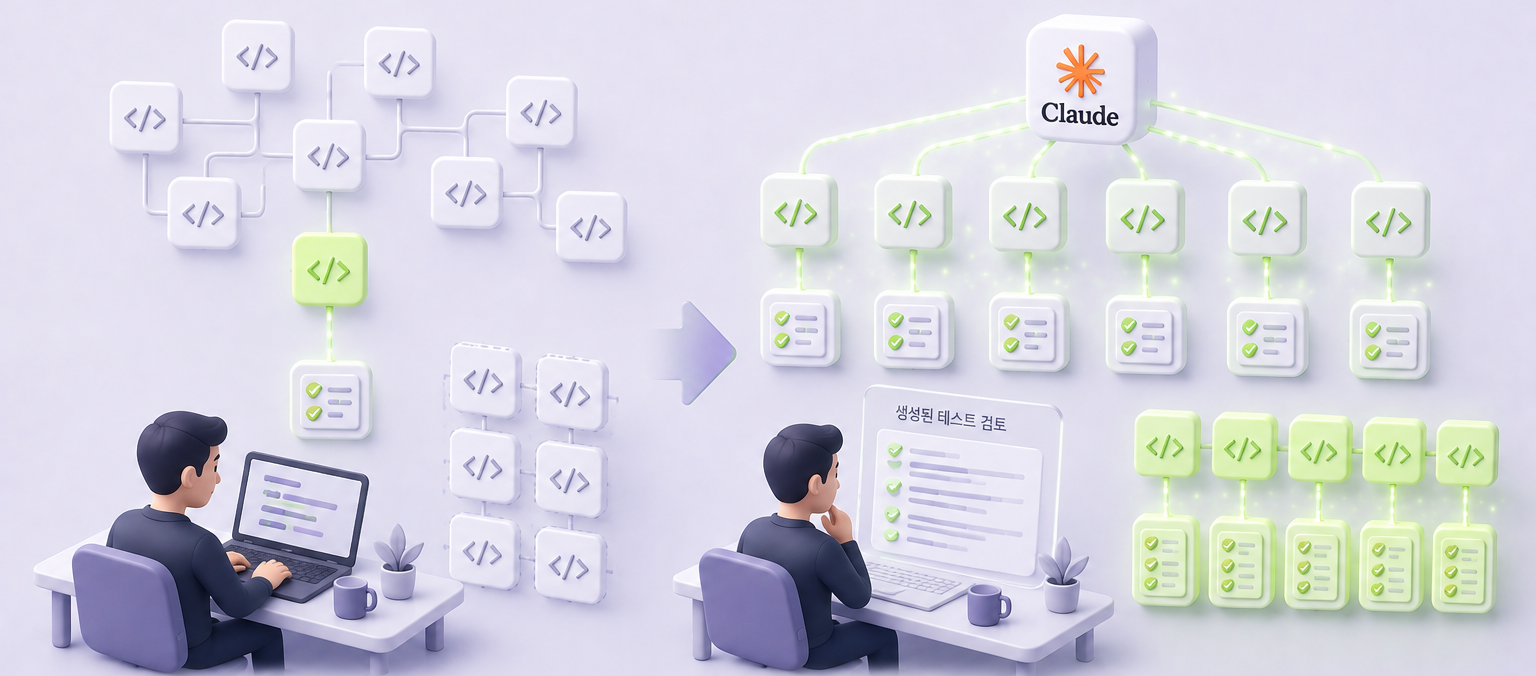
MVVM 핵심 컴포넌트의 테스트 커버리지는
기존 9%에서 30%까지 증가했다.
세부적으로는 Repository, ViewModel, DataSource 등
파이프라인이 주요 대상으로 삼았던 영역에서 테스트가 크게 늘었다.
| 컴포넌트 | 테스트 증가율 |
| Repository | 352% |
| ViewModel | 203% |
| DataSource | 192% |
이 파이프라인은 일회성 실험으로 끝나지 않았다.
현재는 하루 약 20개의 테스트 PR을 생성하는 수준으로 확대되어
지속적으로 기존 코드의 테스트 공백을 채우고 있다.
여기서 중요한 것은 85,000줄이라는 코드 생산량 자체만은 아니다.
사람이 하나씩 작성하던 테스트를 지속적으로 생산할 수 있는 구조가 만들어졌고,
실제로 테스트되는 코드의 범위도 함께 넓어졌다는 점이다.
3) 자동화의 핵심은 Claude Code가 아니었다
지금까지의 과정을 보면 Claude Code가 담당한 역할은 분명하다.
선택된 코드를 분석해 테스트를 만들고,
CI가 실패하면 로그를 바탕으로 다시 수정했다.
하지만 이것만으로 Duolingo의 테스트 자동화가 만들어진 것은 아니다.
어떤 코드에 테스트가 필요한지는 Coverage 데이터와 스코어링을 통해 먼저 결정됐고,
생성된 테스트가 실제로 동작하는지는 CI가 검증했다.
반복해서 실패하는 작업에는 중단 조건을 두었고,
최종적으로 코드를 병합할지는 사람이 판단했다.
즉 Claude Code는 이 시스템의 중심에 있는 도구였지만,
전체 자동화 시스템 그 자체는 아니었다.

Duolingo가 설계한 것은 AI가 테스트를 한 번 잘 작성하게 만드는 방법보다,
AI가 반복해서 테스트를 만들 수 있도록
대상을 정하고, 결과를 검증하고, 실패를 통제하는 구조에 가까웠다.
결국 이 사례의 핵심은 어떤 AI를 사용했느냐만으로 설명하기 어렵다.
AI에게 어떤 일을 맡기고, 그 결과를 기존 개발·검증 과정 안에서 어떻게 통제할 것인가.
Duolingo가 보여준 변화는 AI 모델 자체보다
그 AI를 둘러싼 자동화 구조에 있었다.
4. 테스트 자동화 이후 남은 문제
1) 테스트 생성이 빨라지자 새로운 병목이 생겼다
테스트 생성 자동화가 자리 잡으면서
Duolingo는 필요한 테스트를 이전보다 빠르게 만들어낼 수 있게 됐다.
그런데 파이프라인이 빨라지자 다른 문제가 나타났다.
테스트 PR이 만들어지는 속도가
사람이 리뷰할 수 있는 속도를 앞지르기 시작한 것이다.
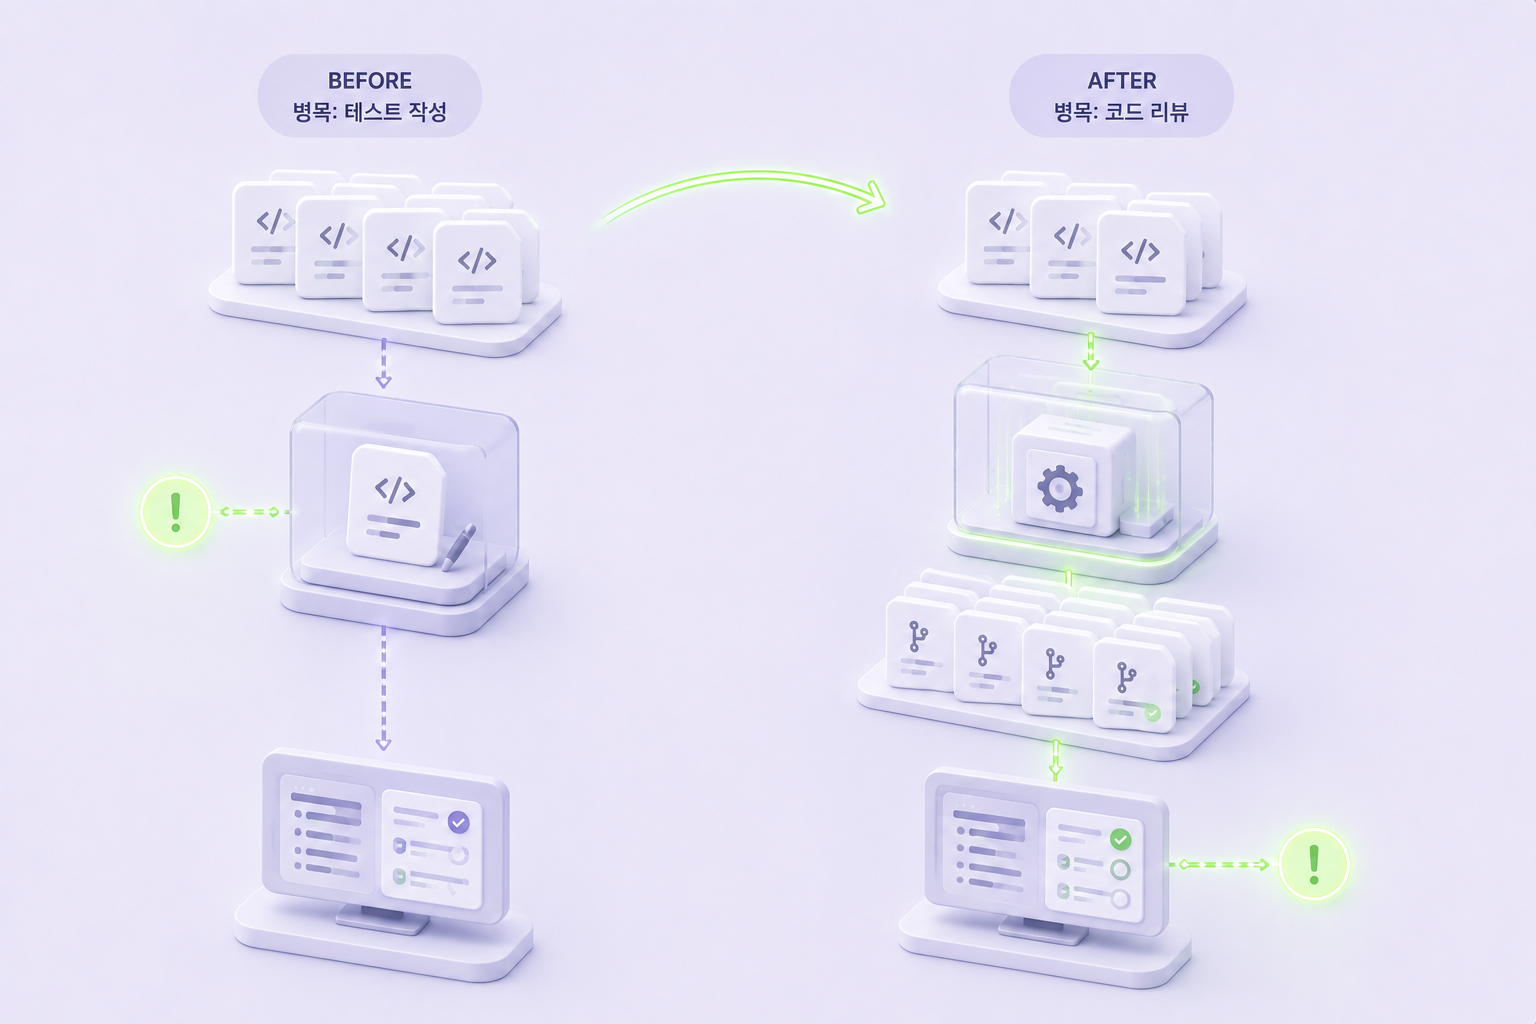
이전에는 필요한 테스트를 작성하는 데 시간이 필요했다면,
이제는 자동으로 만들어진 테스트를 검토하는 데 시간이 필요해졌다.
결국 병목의 위치가 달라졌다.
테스트 작성 → 코드 리뷰
코드를 빠르게 생성할 수 있다는 것과
그 결과를 빠르게 판단할 수 있다는 것은 다른 문제였다.
2) 우리에게 필요한 검증은 무엇일까
Duolingo가 자동화한 것은 단위 테스트였다.
개별 코드가 의도한 대로 동작하는지를 코드 수준에서 확인하는 검증이다.
매주 배포하는 환경에서 테스트 코드 작성이 병목이 되면서 이 영역을 자동화 대상으로 삼았다.
하지만 코드가 정확히 동작한다고 해서
서비스의 품질까지 모두 확인됐다는 뜻은 아니다.
버튼이 의도대로 눌려도 사용자가 그 화면에서 헤맬 수 있고,
로직에 문제가 없어도 실제 기기에서는 느리게 느껴질 수 있다.
이런 문제는 단위 테스트만으로 확인하기 어렵다.
결국 중요한 것은 테스트를 많이 하는 것만이 아니다.
지금 우리 서비스에 부족한 검증이 무엇인지 먼저 확인하는 것이 중요하다.
코드 수준의 검증이 부족할 수도 있고,
사용성을 충분히 확인하지 못하고 있을 수도 있다.
반복적인 회귀 테스트에 시간이 많이 들거나,
성능과 실제 사용 환경에 대한 검증이 부족할 수도 있다.
Duolingo는 자신들의 개발 과정에서 가장 큰 병목을 찾고,
그중 자동화할 수 있는 영역부터 하나씩 채워나갔다.
모든 서비스가 같은 자동화 시스템을 만들 필요는 없다.
먼저 확인해야 할 것은 같다. 지금 우리에게 부족한 검증은 무엇인가.
AI를 활용해 코드를 만드는 속도가 계속 빨라지고 있는 지금,
우리의 검증 방식은 그 속도를 제대로 따라가고 있을까?
서비스마다 필요한 검증은 다릅니다.
T-ASSI 전문 QA팀이 지금 필요한 검증부터 함께 확인합니다.
T-ASSI | 국내 최초 구독형 품질보증 서비스
가벼운 사용성 테스트부터 대규모 프로젝트 개발 검증까지. 소프트웨어 테스트·테스팅을 넘어 제품의 품질을 지속적으로 검증하고 관리하는 구독형 품질보증 서비스, 티어시(T-ASSI)
t-assi.co.kr
'QA Insight > 품질 사례·트렌드' 카테고리의 다른 글
| 2026 QA 자동화 솔루션 현황 (0) | 2026.09.14 |
|---|---|
| 2026 QA 테스트 도구·툴 현황 (0) | 2026.09.14 |
| 2026 국내 QA(품질보증) 아웃소싱 업체 현황 (0) | 2026.09.14 |
| 버그 생산 공장 ACH — Meta의 AI 테스트 자동화 (0) | 2026.09.11 |
| 변화하는 UI를 따라가는 LinkedIn의 AI 테스트 자동화 (0) | 2026.09.03 |